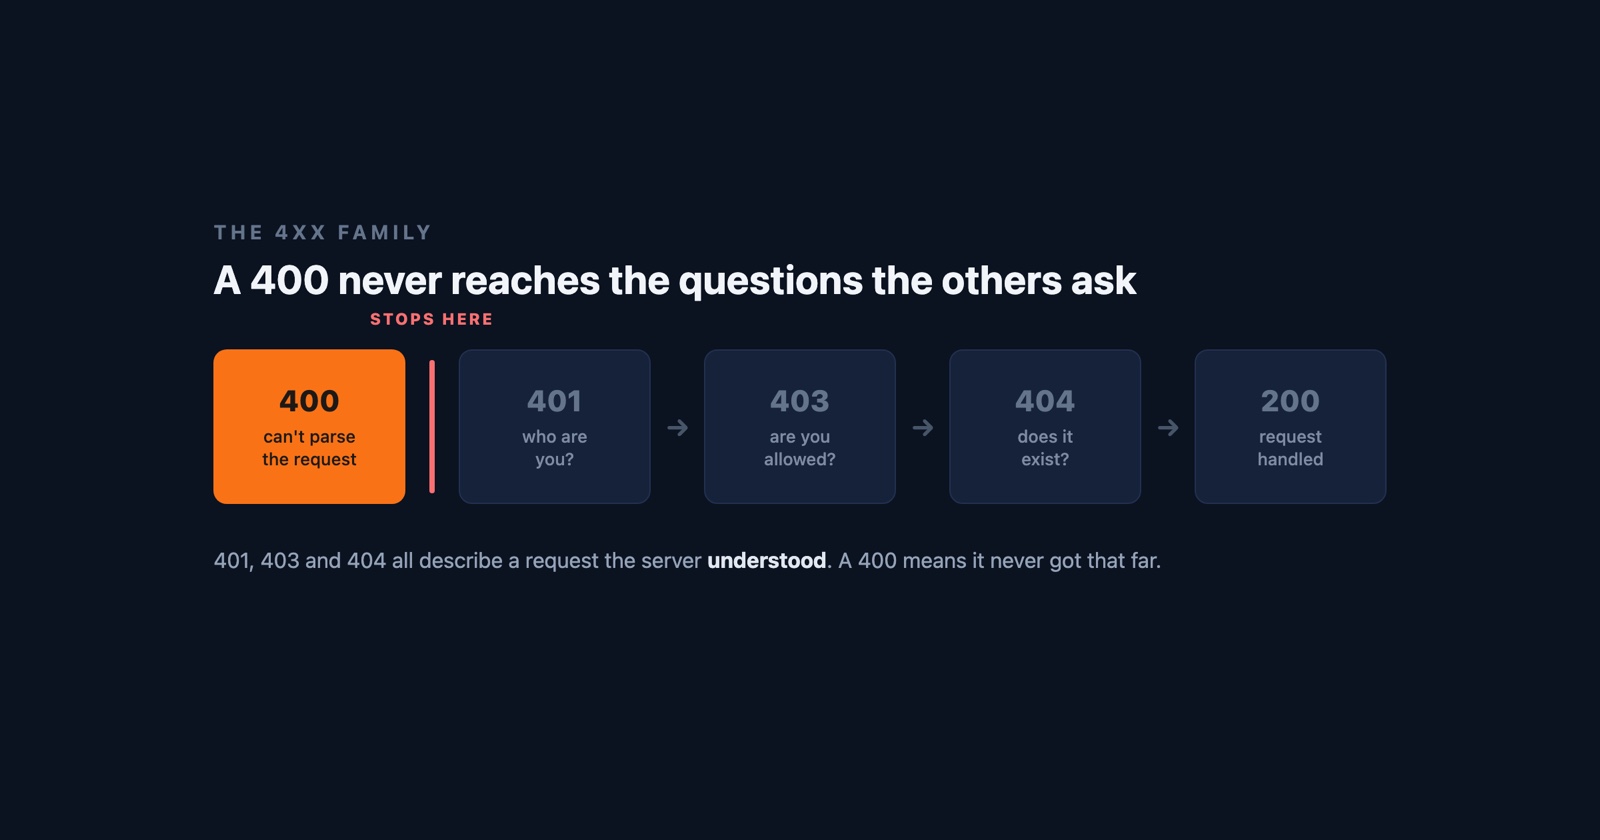
Un 400 Bad Request è il server che si rifiuta perfino di provarci. Ha guardato ciò che è arrivato, ha deciso che era abbastanza malformato da rendere inutile continuare l’analisi, e ha restituito l’unico codice che significa “questa non è una richiesta che io possa leggere”.
È un rifiuto di natura diversa rispetto alla maggior parte degli errori che gli stanno intorno. Un 404 significa che il server vi ha capito perfettamente e non ha nulla a quell’indirizzo. Un 403 significa che vi ha capito e non lo farà. Un 400 significa che non è mai arrivato al punto di capire: la sintassi era sbagliata, un header era malformato, il corpo non aveva la forma che l’endpoint dichiarava. La richiesta è fallita prima ancora che la domanda venisse posta.
La parola “client” sta lavorando parecchio
Qualsiasi riferimento vi dirà che un 4xx è un errore del client, ed è tecnicamente vero e praticamente fuorviante. Il client non siete voi. Il client è il software che ha composto la richiesta, e su un sito moderno quello è quasi sempre il JavaScript della pagina stessa.
Quindi un 400 su un sito che state visitando di solito significa che il loro frontend ha costruito una richiesta che il loro backend non accettava. Il serializzatore di moduli di qualcuno ha inviato una data nel formato sbagliato, una chiamata fetch ha inviato JSON senza dire che era JSON, una query string portava un carattere che nessuno aveva codificato. Il codice di stato incolpa il client, e il client è il loro.
Questo conta perché ribalta il consiglio che accompagna la maggior parte degli errori. Con un 500 la colpa è palesemente del server e non c’è nulla che possiate fare. Con un 400 la colpa suona come vostra, il che manda le persone a svuotare cache e riscrivere URL per venti minuti per un bug che non avrebbero potuto causare.
La famiglia dei 4xx, che viene confusa di continuo
- 400 Bad Request
- La richiesta era malformata. Il server non è riuscito ad analizzarla abbastanza bene da agire, quindi nulla di chi siete o di cosa chiedevate è mai stato preso in considerazione
- 401 Unauthorized
- La richiesta andava bene. Non avete dimostrato chi siete, e il server vuole delle credenziali
- 403 Forbidden
- La richiesta andava bene e sa chi siete. Questo non vi è permesso
- 404 Not Found
- La richiesta andava bene e a quell'indirizzo non c'è nulla
La riga che vale la pena tenere a mente è che solo il 400 riguarda la forma della richiesta. Gli altri tre descrivono tutti una richiesta ben formata che incontra un muro più avanti, ed è per questo che 401 e 403 vengono scambiati l’uno con l’altro così spesso e nessuno dei due viene mai confuso con un 400. Se state ricevendo un 400, smettete di chiedervi dei permessi e cominciate a chiedervi cosa sia stato effettivamente inviato.
L’unico 400 che potete davvero risolvere dalla vostra parte
C’è un’eccezione, ed è abbastanza comune da valere la pena di conoscerla prima di dare il sito per rotto: una richiesta i cui header sono troppo grandi.
I cookie sono header. Un sito che ne ha accumulati per qualche anno, o un flusso di accesso ritentato abbastanza volte da impilare stato di sessione, può spingere il blocco di header oltre il limite che il server è disposto a leggere. La maggior parte dei server risponde con un 400, a volte con una pagina che dice “Request Header Or Cookie Too Large” e spesso con nulla del tutto.
Il segnale è che vi segue su un sito e su nessun altro, sopravvive a un ricaricamento e sparisce all’istante in una finestra privata. Se questo descrive ciò che vedete, cancellare i cookie di quel sito lo risolve, ed è l’unico 400 in cui i soliti rimedi casalinghi sono la risposta vera. Se una finestra privata mostra lo stesso 400, non è questo, e nessuna quantità di pulizia lo toccherà.
Se il sito è vostro
La risposta che l’utente ha ricevuto è quasi vuota per scelta, quindi la causa sta in ciò che è stato inviato e non in ciò che è tornato indietro. Poche cose ne spiegano la maggior parte.
Un corpo malformato o scritto male. Un POST che porta JSON che non si analizza, o che si
analizza e non corrisponde allo schema contro cui l’endpoint valida. Spesso un campo che vale
null dove l’API dichiarava una stringa, o un numero che arriva come "12" perché un
serializzatore di moduli trasforma tutto in stringhe.
Un Content-Type mancante o sbagliato. Un corpo che il server accetterebbe volentieri,
inviato senza dire cosa sia, o etichettato text/plain quando il parser vuole
application/json. La richiesta è ben formata a vedersi e illeggibile per ciò che deve leggerla.
Qualcosa nell’URL che non è mai stato codificato. Uno spazio grezzo, un % vagante che non è
l’inizio di una sequenza di escape, un parametro di query che porta un URL suo con la sua &.
Alcuni di questi vengono rifiutati dal web server prima ancora che la vostra applicazione li
veda, ed è per questo che non lasciano traccia nel log applicativo.
Header che il proxy non accetta. Il caso dei cookie qui sopra, ma anche un header
Authorization sovradimensionato o un header che porta un ritorno a capo. Questi di solito
vengono rifiutati al bordo, da nginx o da una CDN, e il 400 che torna indietro è di quel proxy,
non vostro.
Quest’ultimo gruppo è il motivo per cui un 400 può essere davvero invisibile dall’interno. Se il rifiuto è avvenuto prima che la richiesta raggiungesse il vostro codice, non c’è nessuna riga da trovare nel log applicativo, e potete passare un pomeriggio a cercare un bug in un posto in cui non gli è mai stato permesso di arrivare.
Perché un 400 è difficile da inseguire a posteriori
Un 400 è interamente un’affermazione su una richiesta che non esiste più. Quando qualcuno ve ne parla, la cosa malformata se n’è andata: avete un codice di stato, un orario approssimativo e un URL che probabilmente funziona benissimo quando lo digitate voi, perché ciò che si è rotto stava in un header o in un corpo che dalla barra degli indirizzi non potete vedere.
Riprodurlo significa ricostruire la richiesta esatta, il che significa sapere cosa ha inviato la pagina, e quella è proprio l’unica cosa che uno screenshot di una pagina di errore non può dirvi.
Session Replay
Estensione Chrome gratuita. Un clic sulla pagina che si comporta male cattura lo screenshot, la console e il log di rete, e vi dà un link da incollare nel ticket.
Il log di rete è tutto il punto qui. Contiene la richiesta che ha ricevuto il 400 con il suo metodo, i suoi header e il suo corpo, che è esattamente il materiale di cui un 400 si lamenta. Chi prende in carico la segnalazione può leggere cosa è stato inviato invece di tirare a indovinare, e di solito quella è tutta l’indagine.
In un paragrafo
Un 400 Bad Request significa che il server non è riuscito ad analizzare ciò che è arrivato e ha rinunciato prima di prenderlo in considerazione, il che lo rende l’unico 4xx che riguarda la forma della richiesta anziché il permesso o l’esistenza. Si chiama errore del client, ma il client è di solito il JavaScript del sito stesso, quindi come visitatori in genere non c’è nulla da sistemare, con una vera eccezione: un blocco di cookie o di header cresciuto troppo, cosa che una finestra privata conferma in pochi secondi. Se il sito è vostro, guardate cosa è stato inviato: un corpo non analizzabile, un content type mancante, un URL non codificato, o un header che il vostro proxy ha rifiutato prima ancora che il vostro codice girasse.