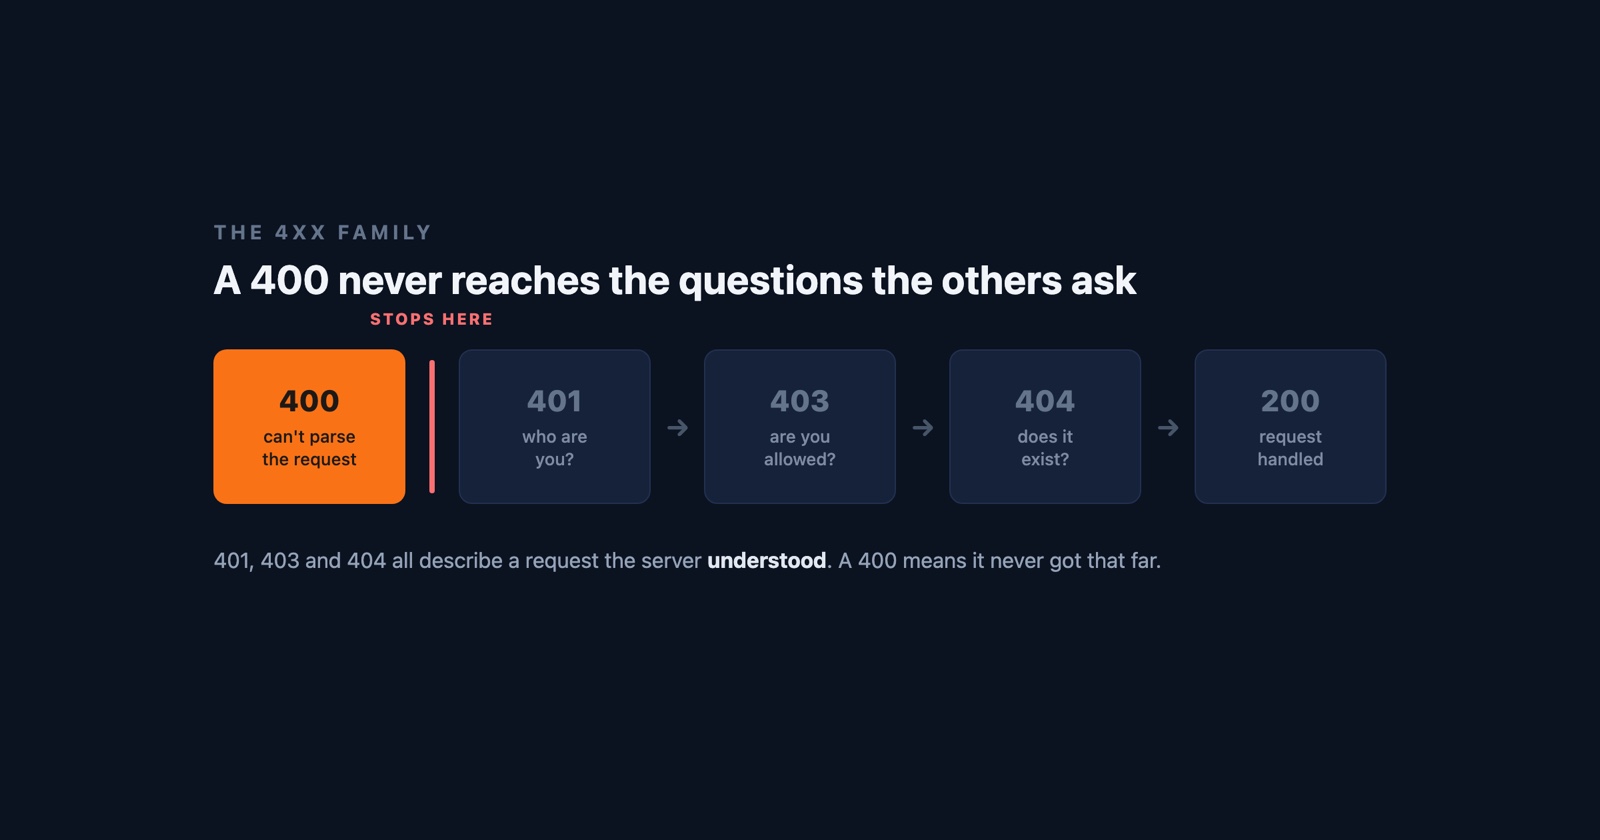
Une erreur 400 Bad Request, c’est le serveur qui refuse même d’essayer. Il a regardé ce qui est arrivé, a décidé que c’était assez mal formé pour qu’il n’y ait aucun intérêt à continuer l’analyse, et a renvoyé le seul code qui signifie “ceci n’est pas une requête que je peux lire”.
C’est un refus d’une autre nature que celui de la plupart des erreurs qui l’entourent. Un 404 signifie que le serveur vous a parfaitement compris et n’a rien à cette adresse. Un 403 signifie qu’il vous a compris et qu’il ne le fera pas. Un 400 signifie qu’il n’est jamais allé jusqu’à comprendre : la syntaxe était fausse, un en-tête était mal formé, le corps n’avait pas la forme que le point d’accès déclarait. La requête a échoué avant même que la question ne soit posée.
Le mot “client” travaille beaucoup ici
Toutes les références vous diront qu’un 4xx est une erreur du client, et c’est techniquement vrai et pratiquement trompeur. Le client, ce n’est pas vous. Le client, c’est le logiciel qui a composé la requête, et sur un site moderne c’est presque toujours le JavaScript de la page elle-même.
Donc une erreur 400 sur un site que vous visitez signifie généralement que leur frontend a construit une requête que leur backend refusait d’accepter. Le sérialiseur de formulaire de quelqu’un a envoyé une date au mauvais format, un appel fetch a posté du JSON sans dire que c’était du JSON, une chaîne de requête portait un caractère que personne n’a échappé. Le code de statut accuse le client, et le client est le leur.
Cela compte parce que cela inverse le conseil qui accompagne la plupart des erreurs. Avec une 500 la faute est manifestement celle du serveur et il n’y a rien que vous puissiez faire. Avec une 400 la faute semble être la vôtre, ce qui envoie les gens vider des caches et retaper des URL pendant vingt minutes pour un bug qu’ils n’auraient pas pu causer.
La famille des 4xx, que l’on confond constamment
- 400 Bad Request
- La requête était mal formée. Le serveur n'a pas pu l'analyser assez bien pour agir dessus, donc rien de ce que vous êtes ni de ce que vous demandiez n'a jamais été pris en compte
- 401 Unauthorized
- La requête était correcte. Vous n'avez pas prouvé qui vous êtes, et le serveur veut des identifiants
- 403 Forbidden
- La requête était correcte et il sait qui vous êtes. Vous n'avez pas droit à ceci
- 404 Not Found
- La requête était correcte et il n'y a rien à cette adresse
La ligne qui mérite d’être retenue est que seule la 400 concerne la forme de la requête. Les trois autres décrivent toutes une requête bien formée qui rencontre un mur plus loin, ce qui explique pourquoi 401 et 403 sont si souvent intervertis et pourquoi ni l’un ni l’autre n’est jamais confondu avec une 400. Si vous obtenez une 400, cessez de poser des questions sur les permissions et commencez à demander ce qui a réellement été envoyé.
La seule 400 que vous pouvez vraiment corriger de votre côté
Il y a une exception, et elle est assez courante pour valoir la peine d’être connue avant de déclarer le site cassé : une requête dont les en-têtes sont trop volumineux.
Les cookies sont des en-têtes. Un site qui en a accumulé quelques années, ou un parcours de connexion réessayé assez souvent pour empiler de l’état de session, peut pousser le bloc d’en-têtes au-delà de la limite que le serveur accepte de lire. La plupart des serveurs répondent à cela par une 400, parfois avec une page qui affiche “Request Header Or Cookie Too Large” et souvent avec rien du tout.
Le signe est que cela vous suit sur un site et sur aucun autre, survit à un rechargement et disparaît instantanément dans une fenêtre privée. Si cela décrit ce que vous voyez, supprimer les cookies de ce site le corrige, et c’est la seule 400 où les remèdes de grand-mère habituels sont la vraie réponse. Si une fenêtre privée montre la même 400, ce n’est pas cela, et aucun nettoyage n’y changera quoi que ce soit.
Si le site est le vôtre
La réponse reçue par l’utilisateur est presque vide par conception, donc la cause est dans ce qui a été envoyé plutôt que dans ce qui est revenu. Une poignée de choses en explique la plupart.
Un corps mal formé ou mal saisi. Un POST portant du JSON qui ne s’analyse pas, ou qui
s’analyse et ne correspond pas au schéma contre lequel le point d’accès valide. Souvent un champ
qui vaut null là où l’API déclarait une chaîne, ou un nombre qui arrive sous la forme "12"
parce qu’un sérialiseur de formulaire transforme tout en chaînes.
Un Content-Type absent ou incorrect. Un corps que le serveur accepterait volontiers, envoyé
sans dire ce qu’il est, ou étiqueté text/plain alors que l’analyseur veut application/json.
La requête est bien formée à regarder et illisible pour ce qui doit la lire.
Quelque chose dans l’URL qui n’a jamais été échappé. Une espace brute, un % égaré qui n’est
pas le début d’une séquence d’échappement, un paramètre de requête portant sa propre URL avec son
propre &. Certains sont rejetés par le serveur web avant même que votre application les voie,
c’est pourquoi ils ne laissent aucune trace dans votre journal applicatif.
Des en-têtes que le proxy refuse. Le cas des cookies ci-dessus, mais aussi un en-tête
Authorization surdimensionné ou un en-tête portant un saut de ligne. Ceux-là sont généralement
refusés en périphérie, par nginx ou un CDN, et la 400 qui revient est celle de ce proxy, pas la
vôtre.
Ce dernier groupe est la raison pour laquelle une 400 peut être réellement invisible de l’intérieur. Si le rejet s’est produit avant que la requête n’atteigne votre code, il n’y a aucune ligne à trouver dans votre journal applicatif, et vous pouvez passer un après-midi à chercher un bug dans un endroit où il n’a jamais eu le droit d’arriver.
Pourquoi une 400 est difficile à traquer après coup
Une 400 est entièrement une affirmation portant sur une requête qui n’existe plus. Au moment où quelqu’un vous en parle, la chose mal formée a disparu : vous avez un code de statut, une heure approximative et une URL qui fonctionne probablement très bien quand vous la tapez vous-même, parce que ce qui a cassé se trouvait dans un en-tête ou un corps que vous ne pouvez pas voir depuis la barre d’adresse.
La reproduire signifie reconstruire la requête exacte, ce qui signifie savoir ce que la page a envoyé, et c’est justement la seule chose qu’une capture d’écran d’une page d’erreur ne peut pas vous dire.
Session Replay
Extension Chrome gratuite. Un clic sur la page qui se comporte mal capture la capture d'écran, la console et le journal réseau, et vous donne un lien à coller dans le ticket.
Le journal réseau est tout l’intérêt ici. Il contient la requête qui a reçu la 400 avec sa méthode, ses en-têtes et son corps, ce qui est exactement le matériau dont une 400 se plaint. Celui qui reprend le rapport peut lire ce qui a été envoyé au lieu de le deviner, et c’est généralement toute l’enquête.
En un paragraphe
Une erreur 400 Bad Request signifie que le serveur n’a pas pu analyser ce qui est arrivé et a renoncé avant de l’examiner, ce qui en fait la seule 4xx qui porte sur la forme de la requête plutôt que sur la permission ou l’existence. On l’appelle erreur du client, mais le client est généralement le JavaScript du site lui-même, donc en tant que visiteur il n’y a en général rien à corriger, avec une vraie exception : un bloc de cookies ou d’en-têtes devenu trop gros, ce qu’une fenêtre privée confirme en quelques secondes. Si le site est le vôtre, regardez ce qui a été envoyé : un corps inanalysable, un content type manquant, une URL non échappée, ou un en-tête que votre proxy a refusé avant même que votre code ne s’exécute.