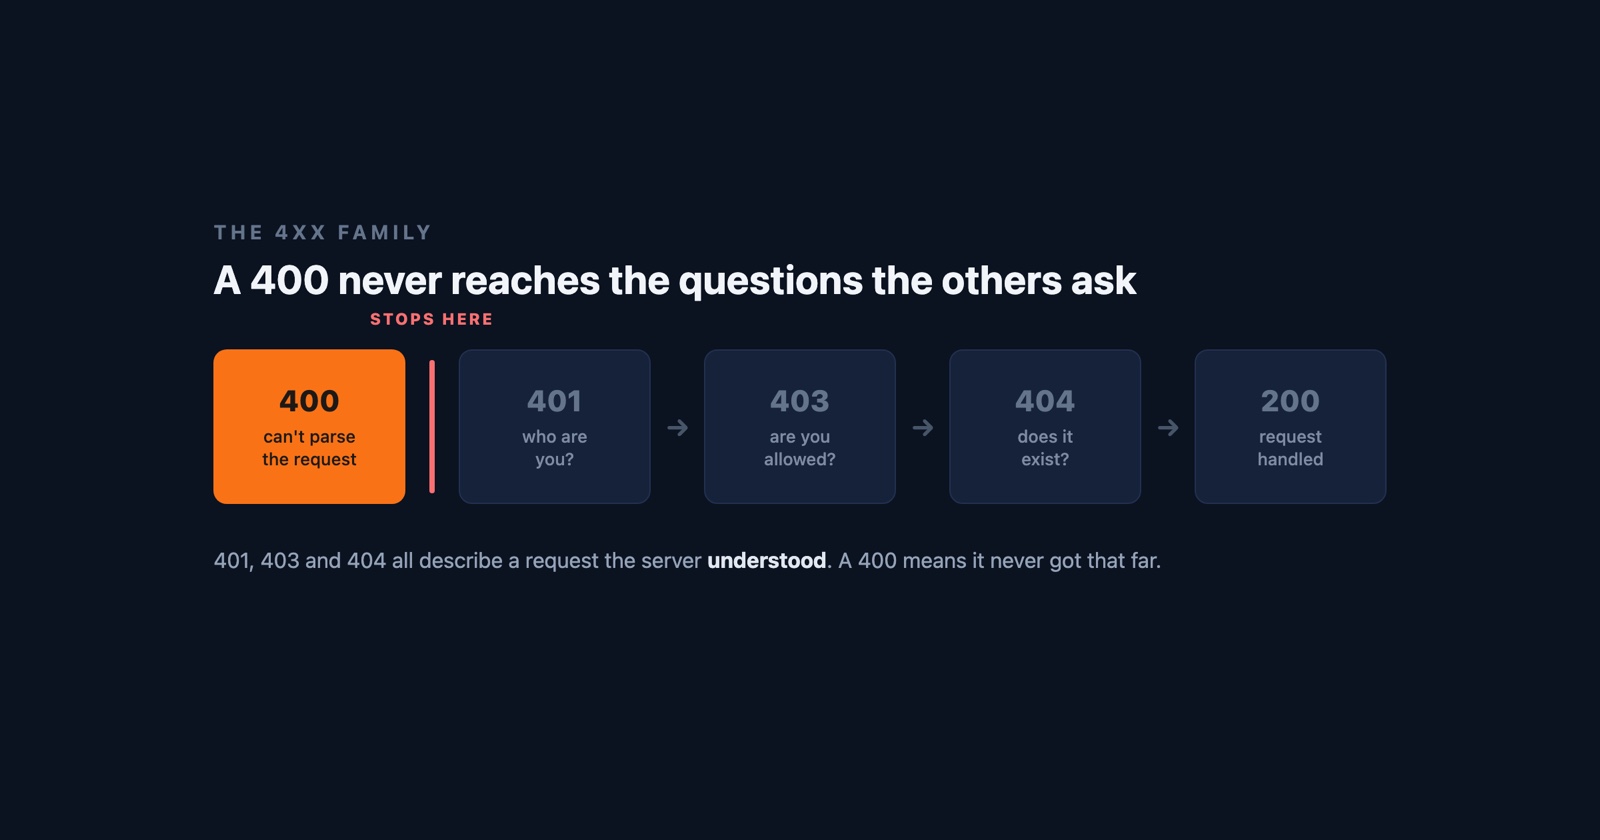
Un 400 Bad Request es el servidor negándose incluso a intentarlo. Miró lo que llegó, decidió que estaba lo bastante malformado como para que no tuviera sentido seguir analizándolo, y devolvió el único código que significa “esta no es una petición que yo pueda leer”.
Ese es un tipo de rechazo distinto al de la mayoría de los errores que lo rodean. Un 404 significa que el servidor le entendió perfectamente y no tiene nada en esa dirección. Un 403 significa que le entendió y no lo va a hacer. Un 400 significa que nunca llegó tan lejos como para entender: la sintaxis estaba mal, una cabecera estaba malformada, el cuerpo no tenía la forma que el endpoint declaraba. La petición falló antes de que la pregunta llegara a formularse.
La palabra “cliente” está haciendo mucho trabajo aquí
Cualquier referencia le dirá que un 4xx es un error del cliente, y eso es técnicamente cierto y en la práctica engañoso. El cliente no es usted. El cliente es el software que compuso la petición, y en un sitio moderno eso es casi siempre el propio JavaScript de la página.
Así que un 400 en un sitio que usted visita normalmente significa que su frontend construyó una petición que su backend no aceptaba. El serializador de formularios de alguien envió una fecha en el formato equivocado, una llamada fetch publicó JSON sin decir que era JSON, una cadena de consulta llevaba un carácter que nadie escapó. El código de estado culpa al cliente, y el cliente es suyo.
Esto importa porque invierte el consejo que acompaña a la mayoría de los errores. Con un 500 la culpa es obviamente del servidor y usted no puede hacer nada. Con un 400 la culpa suena a suya, lo que manda a la gente a veinte minutos de limpiar cachés y reescribir URLs por un fallo que no podría haber causado.
La familia 4xx, que se confunde constantemente
- 400 Bad Request
- La petición estaba malformada. El servidor no pudo analizarla lo bastante bien como para actuar sobre ella, así que nunca se consideró quién es usted ni qué pedía
- 401 Unauthorized
- La petición estaba bien. Usted no ha demostrado quién es, y el servidor quiere credenciales
- 403 Forbidden
- La petición estaba bien y sabe quién es usted. Esto no le está permitido
- 404 Not Found
- La petición estaba bien y no hay nada en esa dirección
La línea que merece la pena retener es que solo el 400 trata de la forma de la petición. Los otros tres describen todos una petición bien formada que choca con un muro más adentro, que es por lo que el 401 y el 403 se intercambian entre sí tan a menudo y ninguno de los dos se confunde jamás con un 400. Si está recibiendo un 400, deje de preguntar por permisos y empiece a preguntar qué se envió realmente.
El único 400 que sí puede arreglar desde su lado
Hay una excepción, y es lo bastante común como para conocerla antes de dar el sitio por roto: una petición cuyas cabeceras son demasiado grandes.
Las cookies son cabeceras. Un sitio que ha acumulado unos cuantos años de ellas, o un flujo de inicio de sesión que se ha reintentado las veces suficientes como para apilar estado de sesión, puede empujar el bloque de cabeceras más allá del límite que el servidor está dispuesto a leer. La mayoría de los servidores responden a eso con un 400, a veces con una página que dice “Request Header Or Cookie Too Large” y a menudo sin nada en absoluto.
La señal es que le sigue por un sitio y por ningún otro, sobrevive a una recarga y desaparece al instante en una ventana privada. Si eso describe lo que está viendo, borrar las cookies de ese sitio lo arregla, y es el único 400 en el que los remedios caseros de siempre son la respuesta de verdad. Si una ventana privada muestra el mismo 400, no es esto, y ninguna cantidad de borrado va a tocarlo.
Si el sitio es suyo
La respuesta que recibió el usuario está casi vacía por diseño, así que la causa está en lo que se envió y no en lo que volvió. Un puñado de cosas explica la mayoría de ellos.
Un cuerpo malformado o mal escrito. Un POST que lleva JSON que no se analiza, o que se
analiza y no coincide con el esquema contra el que valida el endpoint. A menudo un campo que es
null donde la API declaraba una cadena, o un número que llega como "12" porque un serializador
de formularios convierte todo en cadenas.
Un Content-Type que falta o es incorrecto. Un cuerpo que el servidor aceptaría encantado,
enviado sin decir qué es, o etiquetado como text/plain cuando el analizador quiere
application/json. La petición está bien formada a la vista y es ilegible para lo que tiene que
leerla.
Algo en la URL que nunca se escapó. Un espacio en crudo, un % perdido que no es el comienzo
de una secuencia de escape, un parámetro de consulta que lleva una URL propia con su propio &.
Algunos de estos los rechaza el servidor web antes de que su aplicación llegue a verlos, que es
por lo que no dejan rastro en el log de la aplicación.
Cabeceras que el proxy no acepta. El caso de las cookies de arriba, pero también una cabecera
Authorization de tamaño excesivo o una cabecera que lleva un salto de línea. Estas suelen
rechazarse en el borde, por nginx o por una CDN, y el 400 que vuelve es de ese proxy, no suyo.
Ese último grupo es la razón por la que un 400 puede ser genuinamente invisible desde dentro. Si el rechazo ocurrió antes de que la petición llegara a su código, no hay ninguna línea en el log de su aplicación que encontrar, y puede pasarse una tarde buscando un fallo en un sitio al que nunca se le permitió llegar.
Por qué un 400 es difícil de perseguir a posteriori
Un 400 es enteramente una afirmación sobre una petición que ya no existe. Para cuando alguien se lo cuenta, lo malformado ya se ha ido: usted tiene un código de estado, una hora aproximada y una URL que probablemente funciona perfectamente cuando la escribe usted mismo, porque lo que se rompió estaba en una cabecera o en un cuerpo que no puede ver desde la barra de direcciones.
Reproducirlo significa reconstruir la petición exacta, lo que significa saber qué envió la página, y eso es justo lo único que una captura de pantalla de una página de error no le puede decir.
Session Replay
Extensión gratuita de Chrome. Un clic en la página que se comporta mal captura la captura de pantalla, la consola y el registro de red, y le da un enlace para pegar en el ticket.
El registro de red es todo el asunto aquí. Contiene la petición que recibió el 400 con su método, sus cabeceras y su cuerpo, que es exactamente el material del que un 400 se queja. Quien recoja el informe puede leer lo que se envió en lugar de adivinarlo, y eso suele ser toda la investigación.
En un párrafo
Un 400 Bad Request significa que el servidor no pudo analizar lo que llegó y se rindió antes de considerarlo, lo que lo convierte en el único 4xx que trata de la forma de la petición en lugar de tratar de permisos o de existencia. Se llama error del cliente, pero el cliente suele ser el propio JavaScript del sitio, así que como visitante por lo general no hay nada que arreglar, con una excepción real: un bloque de cookies o de cabeceras que ha crecido demasiado, algo que una ventana privada confirma en segundos. Si el sitio es suyo, mire lo que se envió: un cuerpo inanalizable, un content type que falta, una URL sin escapar, o una cabecera que su proxy rechazó antes de que su código llegara a ejecutarse.