Um 404 é o único erro desta lista que normalmente está a funcionar correctamente. O servidor percebeu o pedido perfeitamente, procurou o que lhe pediu, e ali não estava nada. Não rebentou nada e não há nada mal configurado. Pediu uma coisa que não existe, e ele disse-o.
É por isso que um 404 na barra de endereço raramente vale a pena perseguir. O link era antigo, a página mudou, alguém escreveu mal. É a falha mais aborrecida da web.
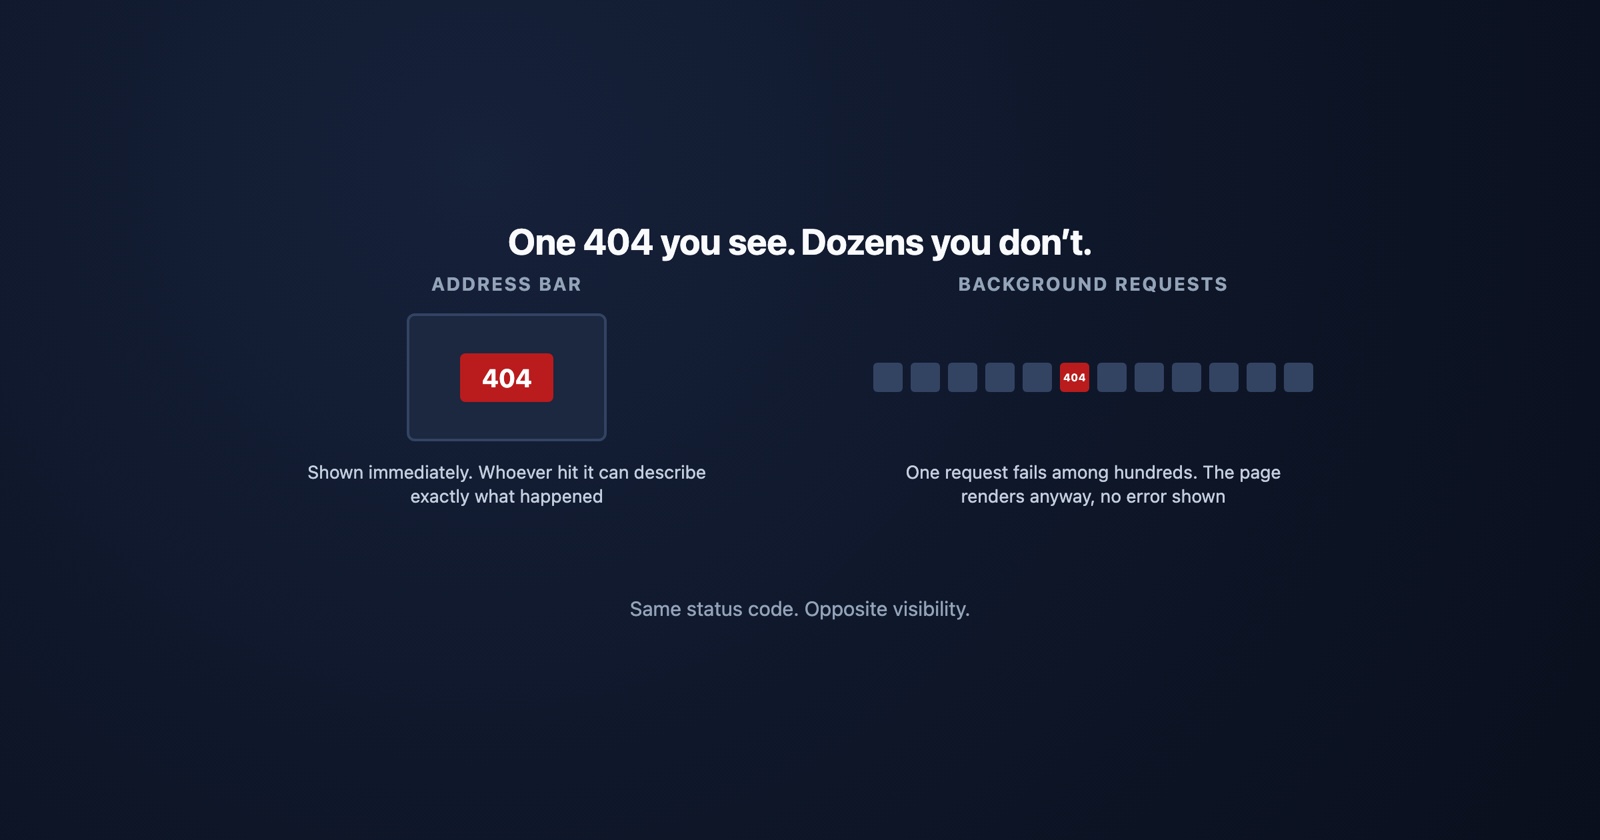
Os interessantes nunca chegam à barra de endereço.
O 404 que vê contra o 404 que não vê
Quando escreve um endereço e apanha um 404, o navegador mostra-lhe uma página e a história acaba ali. Sabe exactamente o que aconteceu.
Quando a página em que já está pede alguma coisa em segundo plano e recebe um 404, nada lho diz.
Uma folha de estilos que não chega deixa o layout com ar partido mas renderizado. Um script que dá
404 significa que uma funcionalidade não faz nada em silêncio. Um fetch de dados devolve um
corpo 404 que o código tenta analisar como JSON, e o que vem à superfície é um
TypeError, a vários
passos do problema verdadeiro.
Esta é a versão que produz o relato que todo o programador já leu: “a página está esquisita”, ou “o botão não faz nada”. Nenhuma mensagem de erro, porque não houve página de erro. A falha aconteceu no registo de rede, e ninguém estava a olhar para o registo de rede.
Duzentos pedidos podem compor uma página moderna. Qualquer um deles pode dar 404 sem parar os outros cento e noventa e nove.
Porque é que um 404 em segundo plano normalmente significa um deploy
Um 404 na barra de endereço é o link de alguém. Um 404 num recurso que a própria página pediu é quase sempre a build.
Um ficheiro renomeado ou com impressão digital. Os pipelines de assets metem um hash do conteúdo no nome do ficheiro. Se o HTML está em cache e aponta para o hash antigo enquanto o deploy novo entregou outro, o navegador pede um ficheiro que de facto já não existe. Isto resolve-se sozinho para a maioria das pessoas ao recarregar e persiste para quem tenha uma página em cache, e é por isso que tantas vezes é reportado por uma pessoa e ninguém mais o consegue reproduzir.
Um ficheiro que nunca foi carregado. Um passo da build que falhou em silêncio, um asset
excluído por uma mudança de configuração, um caminho que funciona localmente por causa de sistemas
de ficheiros que ignoram maiúsculas e falha num servidor Linux porque Logo.svg não é logo.svg.
Uma rota de API que mudou. O front end e o back end foram entregues em momentos ligeiramente diferentes, e durante alguns minutos um pede um endpoint que o outro já renomeou.
Os três são invisíveis a partir da página. Os três são uma linha num registo de rede.
Os soft 404, que são piores do que os 404
Um soft 404 é uma página que diz a um humano que não encontrou nada enquanto diz a todas as
máquinas que está tudo bem: um simpático “desculpe, aqui não há nada” servido com um 200 OK.
Essa combinação é prejudicial de uma maneira que um 404 verdadeiro não é. Os motores de busca
indexam-na como página que funciona, por isso o conteúdo em falta fica nos resultados. A
monitorização nunca dispara, porque a monitorização conta códigos de estado. E qualquer código que
verifique response.ok antes de analisar toma a página de erro por dados e falha mais à frente,
com uma mensagem sobre a forma do JSON em vez de sobre a página estar em falta.
Se levar uma coisa desta página: uma página de erro tem de devolver um estado de erro. Uma mensagem que um humano consiga ler e um código de estado verdadeiro não são alternativas um ao outro.
O 404 contra os códigos com que é confundido
- 404 Not Found
- O pedido estava bem e não há nada nesse endereço. Não diz nada sobre se alguma vez houve
- 410 Gone
- Aqui havia alguma coisa e foi removida deliberada e permanentemente. Os motores de busca largam-na mais depressa
- 403 Forbidden
- Existe e não lhe é permitido. Alguns sites devolvem 404 em vez disso, de propósito, para que ninguém consiga mapear o que existe às apalpadelas
- 400 Bad Request
- O servidor não conseguiu analisar o pedido de todo, por isso nunca chegou a ir ver
Essa terceira linha vale a pena saber-se quando anda a depurar a API de outra pessoa: um 404 num recurso que tem bastante a certeza de que existe pode ser um 403 disfarçado, a esconder a existência da coisa de quem chama sem autorização. Verifique se está autenticado antes de dar o registo por desaparecido.
Se o site é seu
Corrigir o 404 que tem à frente é a metade fácil. O trabalho útil é encontrar os que ninguém reporta.
O log de acesso do servidor tem todos eles com o URL e o referrer, e o referrer é a parte que as pessoas saltam. Diz-lhe qual das suas próprias páginas está a ligar para algo em falta, o que transforma uma lista de 404 numa lista de bugs. A Search Console faz o mesmo trabalho para tudo o que é alcançável de fora.
Depois decida o que cada um deve ser. Uma página que mudou quer um redireccionamento para o que a substituiu, não para a página inicial, coisa que os motores de busca tratam como soft 404 e os leitores vivem como serem ignorados. Algo apagado a sério quer um 410. Uma gralha que ninguém liga não quer nada: os 404 são normais, e um site sem nenhum é um site a redireccionar coisas que não devia.
Porque é que os invisíveis são difíceis de reportar
Um 404 em segundo plano deixa quem o vê sem nada para descrever. Tem uma página com mau aspecto, nenhuma mensagem de erro, e nenhuma razão para pensar que um ficheiro não carregou. Por isso o relato é “está partido no meu computador”, e o programador abre a página, vê-a funcionar, e fecha o ticket.
Session Replay
Extensão gratuita do Chrome. Um clique na página que se está a portar mal captura a captura de ecrã, a consola e o registo de rede, e dá-lhe um link para colar no ticket.
O registo de rede é toda a diferença aqui. Um 404 num pedido que a página fez é invisível no ecrã e óbvio no registo, por isso um relato que o leve transforma “está esquisita” num nome de ficheiro e num número de linha. Isso é normalmente a investigação inteira.
Num parágrafo
Um 404 significa que o servidor o percebeu e não tem nada nesse endereço, o que faz dele o único erro que normalmente se está a comportar correctamente. Os da barra de endereço são o link caducado de alguém e raramente importam. Os que importam são os pedidos que uma página faz em segundo plano, onde uma folha de estilos, um script ou uma rota de API em falta produzem uma página com mau aspecto e sem mensagem de erro nenhuma, e que quase sempre remontam a um deploy: um nome de ficheiro com impressão digital, um ficheiro que nunca foi carregado, ou uma rota que mudou. Sirva os 404 verdadeiros com um estado 404 em vez de um simpático 200, porque um soft 404 engana os motores de busca e a monitorização ao mesmo tempo. E se anda atrás de um, o referrer no seu log de acesso é o que transforma uma lista de URLs em falta numa lista de páginas que ligam para elas.