Une 404 est la seule erreur de cette liste qui fonctionne généralement correctement. Le serveur a parfaitement compris la requête, a cherché ce que vous demandiez, et il n’y avait rien. Rien n’a planté et rien n’est mal configuré. Vous avez demandé une chose qui n’existe pas, et il l’a dit.
C’est pourquoi une 404 dans la barre d’adresse mérite rarement qu’on la poursuive. Le lien était vieux, la page a déménagé, quelqu’un s’est trompé en tapant. C’est la panne la plus ennuyeuse du web.
Les intéressantes n’atteignent jamais la barre d’adresse.
La 404 que vous voyez contre celle que vous ne voyez pas
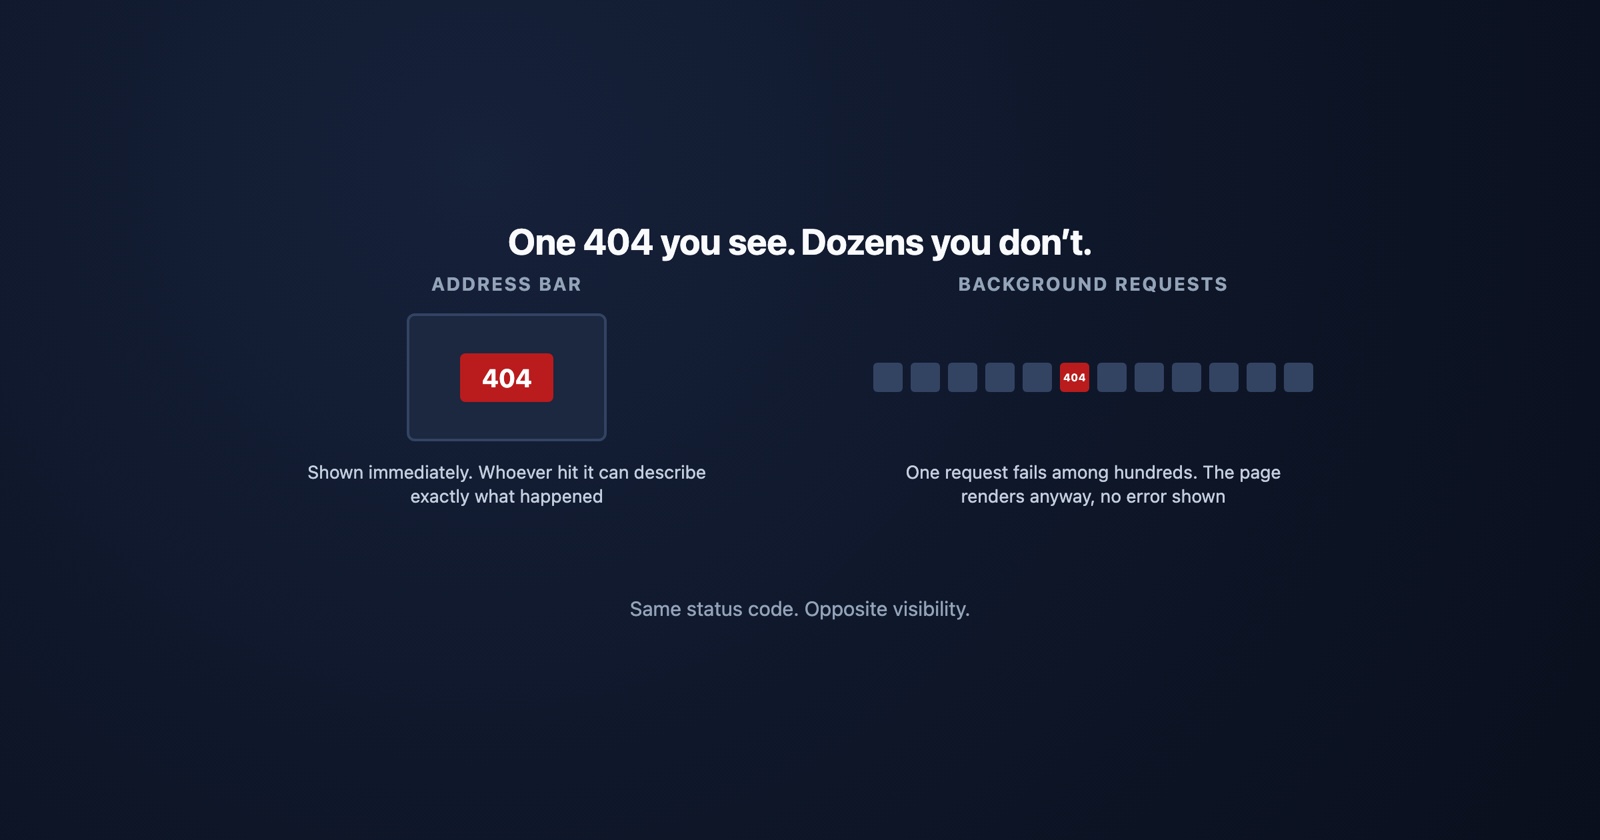
Quand vous tapez une adresse et obtenez une 404, le navigateur vous montre une page et l’histoire s’arrête là. Vous savez exactement ce qui s’est passé.
Quand la page où vous êtes déjà demande quelque chose en arrière-plan et reçoit une 404, rien ne
vous le dit. Une feuille de style qui n’arrive pas laisse la mise en page cassée mais rendue. Un
script en 404 signifie qu’une fonctionnalité ne fait silencieusement rien. Un fetch de données
renvoie un corps de 404 que le code tente d’analyser comme du JSON, et ce qui remonte est un
TypeError, à plusieurs
pas du vrai problème.
C’est la version qui produit le signalement que tout développeur a lu : « la page est bizarre », ou « le bouton ne fait rien ». Aucun message d’erreur, parce qu’il n’y a pas eu de page d’erreur. La défaillance s’est produite dans le journal réseau, et personne ne regardait le journal réseau.
Deux cents requêtes peuvent composer une page moderne. N’importe laquelle peut renvoyer une 404 sans arrêter les cent quatre-vingt-dix-neuf autres.
Pourquoi une 404 en arrière-plan signifie généralement un déploiement
Une 404 dans la barre d’adresse est le lien de quelqu’un. Une 404 sur une ressource que la page elle-même a demandée, c’est presque toujours le build.
Un fichier renommé ou empreinté. Les pipelines d’assets mettent une empreinte du contenu dans le nom de fichier. Si le HTML est en cache et pointe vers l’ancienne empreinte alors que le nouveau déploiement en a livré une autre, le navigateur demande un fichier qui n’existe réellement plus. Cela se règle tout seul au rechargement pour la plupart des gens et persiste pour quiconque garde une page en cache, ce qui explique que ce soit si souvent signalé par une personne et irreproductible pour toutes les autres.
Un fichier qui n’a jamais été téléversé. Une étape de build qui a échoué en silence, une
ressource exclue par un changement de configuration, un chemin qui marche en local grâce aux
systèmes de fichiers insensibles à la casse et échoue sur un serveur Linux parce que Logo.svg
n’est pas logo.svg.
Une route d’API qui a déménagé. Le front et le back ont été livrés à des moments légèrement différents, et pendant quelques minutes l’un demande un point d’accès que l’autre a déjà renommé.
Les trois sont invisibles depuis la page. Les trois sont une ligne dans un journal réseau.
Les soft 404, qui sont pires que les 404
Une soft 404 est une page qui dit à un humain qu’elle n’a rien trouvé tout en disant à chaque
machine que tout va bien : un aimable « désolé, il n’y a rien ici » servi avec un 200 OK.
Cette combinaison est réellement nuisible d’une façon dont une vraie 404 ne l’est pas. Les moteurs
de recherche l’indexent comme une page qui fonctionne, donc le contenu manquant reste dans les
résultats. La supervision ne se déclenche jamais, parce que la supervision compte des codes de
statut. Et tout code qui vérifie response.ok avant d’analyser prend la page d’erreur pour des
données et échoue plus loin, avec un message sur la forme du JSON plutôt que sur la page absente.
Si vous ne retenez qu’une chose de cette page : une page d’erreur doit renvoyer un statut d’erreur. Un message qu’un humain peut lire et un code de statut honnête ne sont pas des alternatives l’un à l’autre.
La 404 face aux codes avec lesquels on la confond
- 404 Not Found
- La requête était correcte et il n'y a rien à cette adresse. Ne dit rien sur le fait qu'il y ait jamais eu quelque chose
- 410 Gone
- Il y avait quelque chose ici et c'est délibérément et définitivement supprimé. Les moteurs de recherche l'abandonnent plus vite
- 403 Forbidden
- Cela existe et vous n'y avez pas droit. Certains sites renvoient 404 à la place, délibérément, pour que personne ne puisse cartographier ce qui existe en sondant
- 400 Bad Request
- Le serveur n'a pas pu analyser la requête du tout, il n'est donc jamais allé jusqu'à regarder
Cette troisième ligne mérite d’être connue quand vous déboguez l’API de quelqu’un d’autre : une 404 sur une ressource dont vous êtes assez sûr qu’elle existe peut être un 403 déguisé, cachant l’existence de la chose à un appelant non autorisé. Vérifiez si vous êtes authentifié avant de conclure que l’enregistrement a disparu.
Si le site est le vôtre
Corriger la 404 qui est devant vous est la moitié facile. Le travail utile consiste à trouver celles que personne ne signale.
Le journal d’accès du serveur les a toutes avec l’URL et le référent, et le référent est la partie que les gens sautent. Il vous dit laquelle de vos propres pages pointe vers quelque chose d’absent, ce qui transforme une liste de 404 en une liste de bugs. La Search Console fait le même travail pour tout ce qui est atteignable depuis l’extérieur.
Décidez ensuite ce que chacune doit devenir. Une page déplacée veut une redirection vers ce qui l’a remplacée, pas vers l’accueil, ce que les moteurs traitent comme une soft 404 et que les lecteurs vivent comme le fait d’être ignorés. Quelque chose de réellement supprimé veut une 410. Une faute de frappe que personne ne lie ne veut rien du tout : les 404 sont normales, et un site qui n’en a aucune est un site qui redirige des choses qu’il ne devrait pas.
Pourquoi les invisibles sont difficiles à signaler
Une 404 en arrière-plan laisse la personne qui la voit sans rien à décrire. Elle a une page qui a l’air fausse, aucun message d’erreur, et aucune raison de penser qu’un fichier n’a pas été chargé. Le signalement est donc « c’est cassé chez moi », et le développeur ouvre la page, la voit fonctionner, et ferme le ticket.
Session Replay
Extension Chrome gratuite. Un clic sur la page qui se comporte mal capture la capture d'écran, la console et le journal réseau, et vous donne un lien à coller dans le ticket.
Le journal réseau fait toute la différence ici. Une 404 sur une requête faite par la page est invisible à l’écran et évidente dans le journal, donc un signalement qui l’emporte transforme « c’est bizarre » en un nom de fichier et un numéro de ligne. C’est généralement toute l’enquête.
En un paragraphe
Une 404 signifie que le serveur vous a compris et n’a rien à cette adresse, ce qui en fait la seule erreur qui se comporte généralement correctement. Celles de la barre d’adresse sont le lien périmé de quelqu’un et comptent rarement. Celles qui comptent sont les requêtes qu’une page fait en arrière-plan, où une feuille de style, un script ou une route d’API manquants produisent une page qui a l’air fausse sans aucun message d’erreur, et qui remontent presque toujours à un déploiement : un nom de fichier empreinté, un fichier jamais téléversé, ou une route déplacée. Servez les vraies 404 avec un statut 404 plutôt qu’avec un aimable 200, car une soft 404 trompe les moteurs de recherche et la supervision en même temps. Et si vous en poursuivez une, le référent dans votre journal d’accès est ce qui transforme une liste d’URL absentes en une liste de pages qui pointent vers elles.