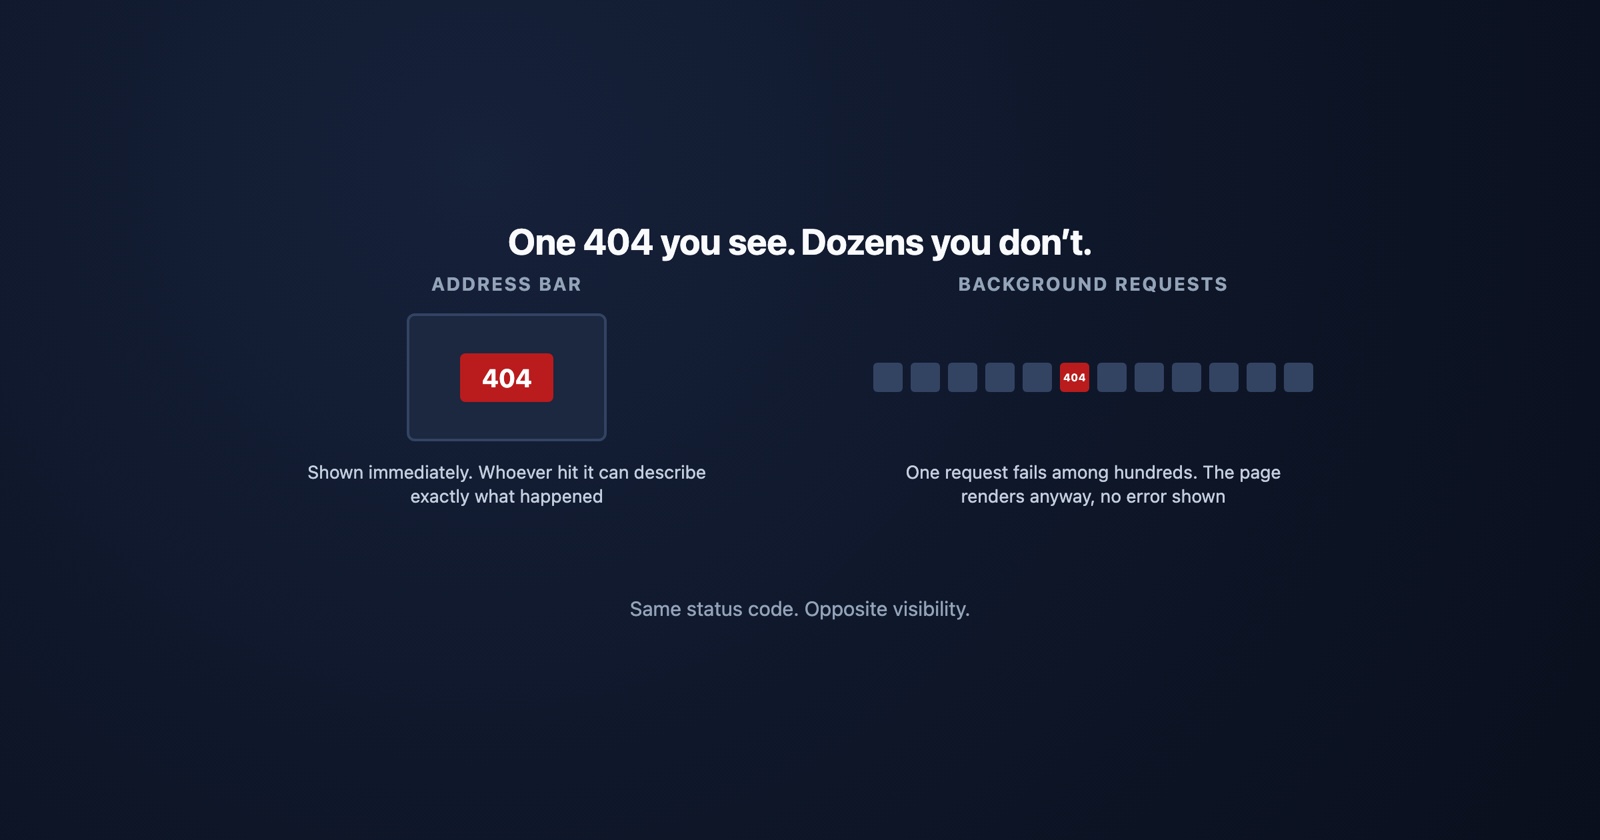
Un 404 è l’unico errore di questo elenco che di solito sta funzionando correttamente. Il server ha capito benissimo la richiesta, ha cercato quello che avete chiesto, e lì non c’era niente. Non è andato in crash niente e non c’è niente di mal configurato. Avete chiesto una cosa che non esiste, e lui lo ha detto.
Ed è per questo che un 404 nella barra degli indirizzi raramente vale la pena di inseguirlo. Il link era vecchio, la pagina si è spostata, qualcuno ha sbagliato a digitare. È il fallimento più noioso del web.
Quelli interessanti non arrivano mai alla barra degli indirizzi.
Il 404 che vedete contro quello che non vedete
Quando digitate un indirizzo e ottenete un 404, il browser vi mostra una pagina e la storia finisce lì. Sapete esattamente cosa è successo.
Quando la pagina su cui siete già chiede qualcosa in background e riceve un 404, non ve lo dice
niente. Un foglio di stile che non arriva lascia il layout dall’aria rotta ma renderizzato. Uno
script che dà 404 significa che una funzione in silenzio non fa nulla. Una fetch di dati
restituisce un corpo 404 che il codice prova ad analizzare come JSON, e quello che viene a galla è
un TypeError, a diversi
passi dal problema vero.
Questa è la versione che produce la segnalazione che ogni sviluppatore ha letto: “la pagina si vede strana”, oppure “il bottone non fa niente”. Nessun messaggio di errore, perché non c’è stata nessuna pagina di errore. Il fallimento è avvenuto nel log di rete, e nessuno stava guardando il log di rete.
Duecento richieste possono comporre una pagina moderna. Una qualsiasi di esse può dare 404 senza fermare le altre centonovantanove.
Perché un 404 in background di solito significa un deploy
Un 404 nella barra degli indirizzi è il link di qualcuno. Un 404 su una risorsa che la pagina stessa ha chiesto è quasi sempre la build.
Un file rinominato o con impronta. Le pipeline degli asset mettono un hash del contenuto nel nome del file. Se l’HTML è in cache e punta al vecchio hash mentre il nuovo deploy ne ha consegnato un altro, il browser chiede un file che davvero non esiste più. Per la maggior parte delle persone si risolve da solo ricaricando e resta per chiunque tenga una pagina in cache, ed è per questo che tante volte lo segnala una persona sola e nessun altro riesce a riprodurlo.
Un file che non è mai stato caricato. Un passo della build fallito in silenzio, un asset
escluso da una modifica di configurazione, un percorso che funziona in locale grazie ai filesystem
che ignorano le maiuscole e fallisce su un server Linux perché Logo.svg non è logo.svg.
Una rotta API che si è spostata. Front end e back end sono stati rilasciati in momenti leggermente diversi, e per qualche minuto uno chiede un endpoint che l’altro ha già rinominato.
Tutti e tre sono invisibili dalla pagina. Tutti e tre sono una riga in un log di rete.
I soft 404, che sono peggio dei 404
Un soft 404 è una pagina che dice a un essere umano che non ha trovato niente mentre dice a ogni
macchina che va tutto bene: un gentile “spiacenti, qui non c’è nulla” servito con un 200 OK.
Quella combinazione è dannosa in un modo in cui un 404 vero non lo è. I motori di ricerca la
indicizzano come pagina funzionante, quindi il contenuto mancante resta nei risultati. Il
monitoraggio non scatta mai, perché il monitoraggio conta i codici di stato. E qualunque codice
controlli response.ok prima di analizzare prende la pagina di errore per dati e fallisce più
avanti, con un messaggio sulla forma del JSON invece che sulla pagina che manca.
Se da questa pagina portate via una cosa sola: una pagina di errore deve restituire uno stato di errore. Un messaggio che un essere umano può leggere e un codice di stato veritiero non sono alternative l’uno all’altro.
Il 404 contro i codici con cui viene confuso
- 404 Not Found
- La richiesta andava bene e a quell'indirizzo non c'è nulla. Non dice niente sul fatto che ci sia mai stato qualcosa
- 410 Gone
- Qui c'era qualcosa ed è stato rimosso deliberatamente e in modo permanente. I motori di ricerca lo lasciano cadere prima
- 403 Forbidden
- Esiste e a voi non è permesso. Alcuni siti restituiscono 404 al suo posto, di proposito, così nessuno può mappare cosa esiste andando a tentativi
- 400 Bad Request
- Il server non è riuscito ad analizzare la richiesta per niente, quindi non è mai arrivato a guardare
Quella terza riga vale la pena saperla quando state facendo debug sull’API di qualcun altro: un 404 su una risorsa che siete abbastanza sicuri esista può essere un 403 travestito, che nasconde l’esistenza della cosa a un chiamante non autorizzato. Controllate se siete autenticati prima di dare il record per sparito.
Se il sito è vostro
Sistemare il 404 che avete davanti è la metà facile. Il lavoro utile è trovare quelli che nessuno segnala.
Il log di accesso del server li ha tutti quanti con l’URL e il referrer, e il referrer è la parte che le persone saltano. Vi dice quale delle vostre pagine sta linkando qualcosa che manca, il che trasforma un elenco di 404 in un elenco di bug. Search Console fa lo stesso lavoro per tutto ciò che è raggiungibile da fuori.
Poi decidete cosa deve essere ciascuno. Una pagina spostata vuole un redirect verso ciò che l’ha sostituita, non verso la home, che i motori di ricerca trattano come un soft 404 e i lettori vivono come l’essere ignorati. Qualcosa cancellato davvero vuole un 410. Un refuso che nessuno linka non vuole niente: i 404 sono normali, e un sito che non ne ha nessuno è un sito che sta redirigendo cose che non dovrebbe.
Perché quelli invisibili sono difficili da segnalare
Un 404 in background lascia chi lo vede senza niente da descrivere. Ha una pagina che sembra sbagliata, nessun messaggio di errore, e nessun motivo di pensare che un file non si sia caricato. Così la segnalazione è “sul mio computer si vede rotto”, e lo sviluppatore apre la pagina, la vede funzionare, e chiude il ticket.
Session Replay
Estensione Chrome gratuita. Un clic sulla pagina che si comporta male cattura lo screenshot, la console e il log di rete, e vi dà un link da incollare nel ticket.
Il log di rete è tutta la differenza qui. Un 404 su una richiesta fatta dalla pagina è invisibile sullo schermo e ovvio nel log, quindi una segnalazione che se lo porta dietro trasforma “si vede strana” in un nome di file e un numero di riga. Di solito quella è tutta l’indagine.
In un paragrafo
Un 404 significa che il server vi ha capito e non ha nulla a quell’indirizzo, il che lo rende l’unico errore che di solito si sta comportando correttamente. Quelli nella barra degli indirizzi sono il link scaduto di qualcuno e raramente contano. Quelli che contano sono le richieste che una pagina fa in background, dove un foglio di stile, uno script o una rotta API mancanti producono una pagina che sembra sbagliata senza nessun messaggio di errore, e che quasi sempre risalgono a un deploy: un nome di file con impronta, un file mai caricato, o una rotta spostata. Servite i 404 veri con uno stato 404 invece che con un gentile 200, perché un soft 404 inganna i motori di ricerca e il monitoraggio nello stesso momento. E se ne state inseguendo uno, il referrer nel vostro log di accesso è ciò che trasforma un elenco di URL mancanti in un elenco di pagine che le linkano.