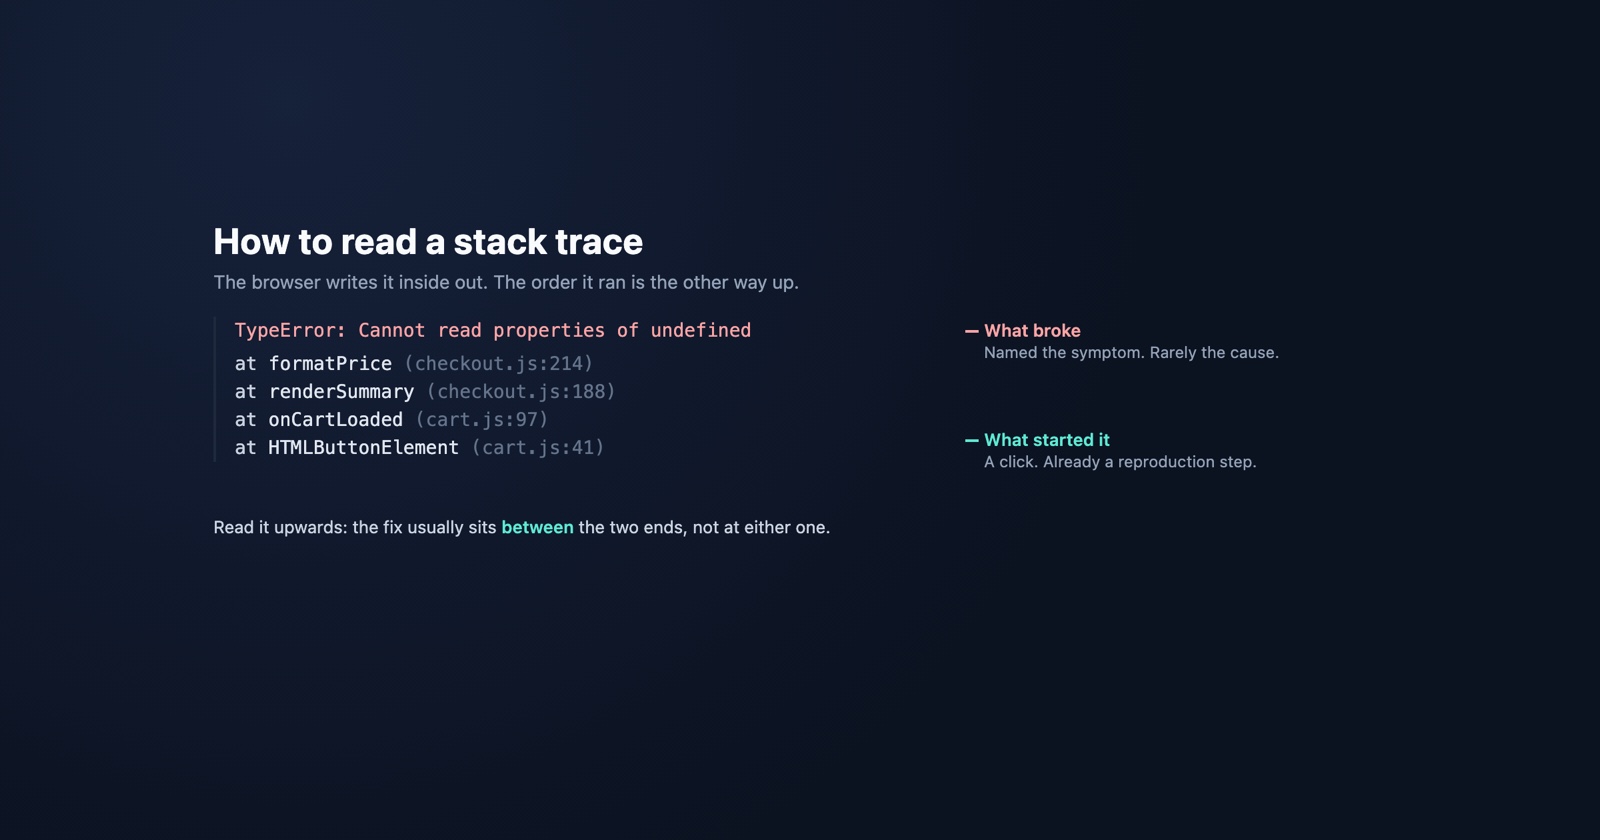
Uno stack trace è l’elenco delle chiamate di funzione che erano in corso nel momento in cui qualcosa ha generato un errore. Il browser lo scrive dall’interno verso l’esterno: la funzione che ha fallito in cima, quella che l’ha chiamata subito sotto, e così via fino a quella che ha dato inizio a tutto.
Ha l’aspetto di un muro di testo e viene trattato come tale. La maggior parte delle persone legge la prima riga, cerca il messaggio e non guarda mai il resto, il che è un peccato, perché la prima riga dice cosa si è rotto e le righe sottostanti dicono perché qualcuno si trovava lì.
Cosa sono davvero le righe
Uno stack trace del browser ha più o meno questo aspetto:
TypeError: Cannot read properties of undefined (reading 'total')
    at formatPrice (checkout.js:214:19)
    at renderSummary (checkout.js:188:7)
    at onCartLoaded (cart.js:97:5)
    at HTMLButtonElement.<anonymous> (cart.js:41:12)
Ci sono quattro elementi, e ciascuno risponde a una domanda diversa.
La prima riga è l’errore: un tipo e un messaggio. Dice cosa è andato storto nel momento in
cui è andato storto, ed è la riga meno utile per trovare la causa. Nell’esempio, qualcosa dentro
formatPrice ha provato a leggere .total da un valore che non c’era, che è il
caso della proprietà undefined
e quasi mai colpa di formatPrice.
Ogni riga at è un frame: una funzione che era in attesa che quella sopra di essa
restituisse un valore. formatPrice è stata chiamata da renderSummary, che a sua volta è
stata chiamata da onCartLoaded.
I numeri indicano file, riga e colonna. checkout.js:214:19 significa riga 214, colonna 19,
un dettaglio che conta quando più chiamate si trovano sulla stessa riga.
Il frame più in basso è l’innesco, ed è di solito la riga più informativa dell’intero
trace. HTMLButtonElement.<anonymous> significa che a scatenare tutto è stato un handler del
click. Qualcosa che ha fatto una persona, non qualcosa che ha fatto la pagina al caricamento.
Questo è già un passo di riproduzione del bug.
Leggerlo dal basso verso l’alto
L’abitudine da coltivare è leggere il trace nell’ordine in cui il codice è stato effettivamente eseguito, cioè dal basso verso l’alto.
È scattato un click. onCartLoaded è stata eseguita. Ha chiamato renderSummary, che ha
chiamato formatPrice, la quale non ha trovato nulla dove si aspettava il totale del carrello.
Letto così, la domanda non è più “cosa non va in formatPrice” ma diventa “cosa aveva in mano
onCartLoaded, e da dove lo aveva preso?” Ed è quasi sempre lì che si trova la soluzione.
- Debole
- Errore in formatPrice, riga 214. Aggiunto un controllo per undefined.
- Migliore
- L'handler del click in cart.js:41 è stato eseguito prima che arrivasse la risposta del carrello, quindi renderSummary ha ricevuto un oggetto vuoto. Corretto l'ordine di esecuzione; formatPrice è rimasta invariata.
La prima versione fa sparire l’errore. La seconda fa sparire il bug. Non sono lo stesso lavoro, e il trace è ciò che permette di distinguerli.
I frame che non appartengono al proprio codice
La maggior parte dei trace reali è più lunga dell’esempio ed è piena di frame provenienti da librerie: React, jQuery, il runtime di un bundler, un polyfill. Nella maggior parte dei casi sono rumore di fondo, ed entrambi i principali browser permettono di nasconderli.
In Chrome DevTools la funzione si chiama Ignore list, sotto Settings, e comprime i frame
degli script indicati, impedendo al debugger di entrarci dentro durante il passo passo. Ignora
già /node_modules/ e /bower_components/ per impostazione predefinita, quindi la prima mossa
utile è spesso aggiungere i propri percorsi delle librerie di terze parti. Il debugger di
Firefox ha la stessa idea, per singolo file, con Ignore source. In entrambi i casi, ogni
trace successivo risulta dimezzato.
Quello che resta è il proprio codice, ovvero la parte che si può modificare.
C’è un’eccezione da tenere d’occhio: se gli unici frame presenti sono quelli delle librerie, la chiamata probabilmente proviene dall’interno di quella libreria e non dal proprio codice, e la causa è solitamente nei dati o nelle opzioni passate.
Perché a volte il trace indica cose senza senso
Tre fattori rendono di norma un trace illeggibile, e tutti e tre dipendono da come il codice è stato distribuito, non dal bug in sé.
Minificazione. In produzione il codice è un’unica riga enorme con nomi di una sola lettera,
quindi il trace mostra qualcosa come at n (app.min.js:1:84213). Il numero di riga è reale ma
inutile. La soluzione sono le source map: la build genera un file .map, il browser lo applica
e DevTools mostra i nomi dei file e le righe originali. Prima di considerare un trace
irrecuperabile, conviene verificare se le proprie source map vengono generate e se il browser
riesce a raggiungerle.
Confini asincroni. Un trace si interrompe dove si interrompe lo stack delle chiamate, e un
setTimeout, il callback di una promise o un event listener ne avviano uno nuovo. Per
impostazione predefinita il frame che ha programmato il lavoro non compare nel trace. In Chrome
la funzione Async stack traces è attiva in DevTools e ricuce i due pezzi insieme, motivo
per cui un trace appare più completo in DevTools rispetto allo stesso errore letto in un file
di log.
Script cross-origin. Se uno script viene servito da un altro dominio senza il permesso di
esporre i propri errori, il browser si rifiuta di dire qualsiasi cosa a riguardo: il messaggio
si riduce alla semplice stringa Script error., senza file, senza riga e senza trace. La
soluzione è lato server: Access-Control-Allow-Origin sullo script, più
crossorigin="anonymous" sul tag. Vale la pena saperlo, perché il sintomo sembra un errore
misterioso mentre in realtà è una regola sui permessi.
Il trace che non è stato raccolto
Tutto quanto detto finora presuppone di avere il trace a disposizione. Il caso scomodo è proprio quello più importante: l’errore si è verificato sul computer di qualcun altro, in un browser che non si ha a disposizione, e ciò che arriva è una singola frase.
Uno stack trace non è qualcosa che si può chiedere a un utente. Vive in un pannello che l’utente non ha mai aperto, sparisce quando chiude la scheda, e la console non sopravvive a un cambio di pagina a meno che qualcuno non abbia pensato ad attivare Preserve log in anticipo. La scelta pratica, quindi, è tra avere un error tracker o uno strumento di report che catturi la console nel momento esatto del guasto, oppure farne a meno.
Senza di esso, il report dice “la pagina di checkout è diventata bianca”, e le quattro righe che avrebbero risolto il mistero in un minuto sono state scartate dal browser pochi secondi dopo.
Session Replay
Estensione gratuita per Chrome. Un clic sulla pagina che si comporta in modo anomalo cattura lo screenshot, la console e il log di rete, e restituisce un link da incollare nel ticket.
Ottenerne uno di proposito
Ci sono due cose utili da sapere per quando serve un trace a comando, invece di aspettare che se ne presenti uno.
console.trace() stampa lo stack delle chiamate corrente senza generare alcun errore, ed è
il modo più rapido per rispondere alla domanda “chi sta chiamando questa funzione?” in una
codebase che non si conosce.
new Error().stack restituisce lo stesso contenuto sotto forma di stringa, che è ciò che gli
error tracker inviano ai propri server. È anche il modo per collegare un trace a un errore
catturato che altrimenti andrebbe perso: intercettare un’eccezione e registrare solo
e.message butta via l’intero stack, ed è un’abitudine responsabile di molti log di
produzione illeggibili.
Cosa portarsi a casa
La prima riga indica il sintomo. L’ultima riga indica cosa lo ha innescato. In mezzo c’è il percorso che le collega, e la soluzione si trova di solito da qualche parte lungo quel percorso, non a uno dei due estremi.
Leggerlo dal basso verso l’alto, nascondere i frame che non appartengono al proprio codice e controllare le source map prima di dare la colpa al trace. E se il trace necessario appartiene alla sessione del browser di qualcun altro, il momento per organizzarsi è prima del bug, non dopo: quando arriva il report, è già sparito.