No sábado 13 de Setembro de 2026, das 09:16 às 10:44 UTC, o GitHub teve aquilo que a sua página de estado classificou como incidente crítico: pedidos à API, Issues, Pull Requests, Actions e Pages degradados durante oitenta e nove minutos. Foi resolvido a meio da manhã na Europa, antes de a maior parte dos Estados Unidos estar acordada, e está prometida uma análise detalhada da causa raiz. Isto não é essa análise, e não adivinha o que ela vai dizer.
Do que trata é de uma frase que o GitHub publicou vinte minutos depois de o incidente começar, porque essa frase é melhor exemplo didáctico do que a maioria dos postmortems consegue ser.
A linha que vale a pena ler duas vezes
Às 09:36 UTC a página de estado dizia:
We’re seeing increased database replication delays on collab which is causing increased error rates in authorization endpoints and follow-on increased error rates across the system.
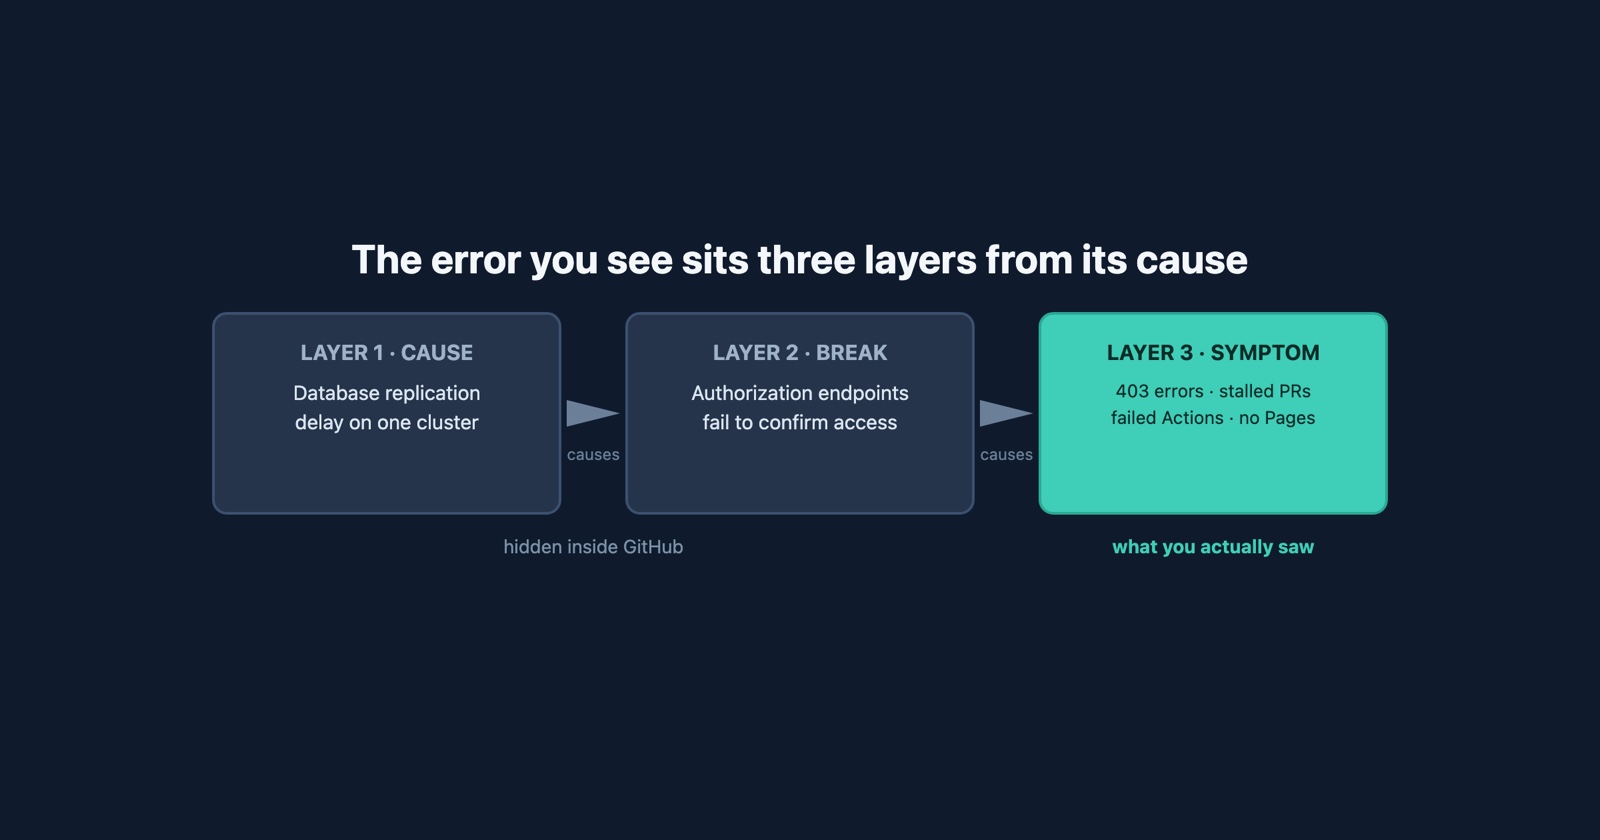
Leia-a como uma cadeia. Um cluster de base de dados ficou para trás na replicação. Isso fez com que os endpoints que decidem se pode fazer alguma coisa começassem a falhar. E como quase tudo faz essa pergunta antes de fazer seja o que for, quase tudo começou a falhar também.
Três camadas: a causa, aquilo que a causa partiu, e as coisas que se partiram por causa disso. Só a última camada era visível para alguém fora do GitHub.
Como se via de onde estava
Se estava a trabalhar no sábado de manhã, não viu um atraso de replicação. Viu uma destas coisas:
- Um
403da API num pedido que ontem funcionava. - Uma página de pull request que não carregava, ou carregava sem as suas verificações.
- Uma execução de Actions que morria com um erro sobre permissões, ou sobre nada em particular.
- Pages a não publicar.
Nenhuma delas diz “uma base de dados está atrasada”. Cada uma diz algo mais próximo de “a sua conta, o seu token ou o seu código estão errados”. Um 403 em particular é o erro que lhe diz que sabe quem é e que a resposta é não, que é uma mensagem com um som muito específico para se receber porque uma réplica algures está uns segundos atrasada.
É essa a forma geral, e merece um nome: o erro que vê é um sintoma, e o sintoma pode estar a várias camadas da causa. As camadas não são um engano. Cada sistema na cadeia reportou com honestidade o que via. O endpoint de autorização não conseguia mesmo confirmar que tinha permissão; a API tinha mesmo de recusar. A mensagem era verdadeira em cada passo e inútil no último.
Porque é que isto importa mais do que a falha
Oitenta e nove minutos num sábado é um incidente pequeno, e o GitHub geriu-o bem: uma entrada de estado em minutos, uma causa enunciada em menos de vinte, descarga de carga para recuperar em vez de esperar que a réplica se pusesse em dia sozinha, e a promessa da análise completa. É assim que se parece fazer bem, e vale a pena dizê-lo.
A razão para o escrever é que a mesma forma de três camadas está por baixo da maioria dos bugs mal reportados, e o sábado é um espécime invulgarmente limpo disso.
Quando alguém diz “apanhei um 403”, está a reportar a camada três. Quando um programador lê “403” e começa a verificar as permissões da pessoa, está a depurar a camada dois. A causa estava na camada um, num sítio que nenhum dos dois conseguia ver, e nem o relatório nem a investigação lá chegam a raciocinar a partir da mensagem. A mensagem é a categoria. Não é o caso. Toda a família de erros HTTP funciona assim: cada um nomeia um tipo de falha e cala a falha concreta.
O que fecha a distância não é uma melhor interpretação do código. São os factos à volta: que pedido, a que horas, ao lado de que mais. No sábado o facto à volta era que toda a gente o estava a ver ao mesmo tempo, que é a pergunta à volta da qual o artigo anterior sobre distinguir o seu bug da falha deles está construído e que não precisa de ser repetida aqui.
O que apontar quando não é toda a gente
O caso difícil é aquele que não está na página de estado de ninguém. O seu próprio sistema tem as mesmas camadas: uma consulta lenta que faz um serviço expirar, que faz uma página falhar. A pessoa que lhe bate recebe a camada três, e o que ela aponta decide se alguém consegue voltar até à camada um.
Por isso o relatório útil não é um diagnóstico. É o sintoma enunciado com exactidão, com a sua hora
e o seu contexto, e sem teoria agarrada. “403 de /repos/x/y/pulls às 09:41 UTC, três tentativas,
a mesma chamada funcionou às 08:50” é um relatório que alguém consegue alinhar com um gráfico de
replicação. “Acho que o meu token expirou” é uma teoria que o manda para a camada errada.
Session Replay
Extensão gratuita do Chrome. Um clique na página que se está a portar mal captura a captura de ecrã, a consola e o registo de rede, e dá-lhe um link para colar no ticket.
O registo de rede é o pedido exacto, o estado exacto e o minuto exacto, capturados sem ninguém ter de decidir que camada acha que está a olhar. É esse o material de que se constrói uma análise de causa raiz, seja a do GitHub ou a sua.
Num parágrafo
A 13 de Setembro de 2026 o GitHub esteve degradado durante oitenta e nove minutos, e a sua própria página de estado nomeou a forma disso numa frase: um atraso de replicação de base de dados num cluster causou falhas nos endpoints de autorização, que causaram falhas em todo o sistema. Três camadas, e só a última era visível de fora, como 403 e páginas que não carregavam. A lição não é sobre o GitHub, que geriu bem e não deve desculpas a ninguém. É que o erro que vê é um sintoma que pode estar a várias camadas da sua causa, por isso o relatório que ajuda é o sintoma enunciado com exactidão, com a sua hora e contexto, em vez de uma teoria sobre o que significa.