Sabato 13 settembre 2026, dalle 09:16 alle 10:44 UTC, GitHub ha avuto quello che la sua pagina di stato ha classificato come incidente critico: richieste API, Issues, Pull Request, Actions e Pages degradati per ottantanove minuti. È stato risolto a metà mattina in Europa, prima che la maggior parte degli Stati Uniti fosse sveglia, ed è promessa un’analisi dettagliata della causa. Questo non è quell’analisi, e non indovina cosa dirà.
Di cosa parla, invece, è di una frase che GitHub ha pubblicato venti minuti dopo l’inizio dell’incidente, perché quella frase è un esempio didattico migliore di quanto riescano a fare la maggior parte dei postmortem.
La riga che vale la pena leggere due volte
Alle 09:36 UTC la pagina di stato diceva:
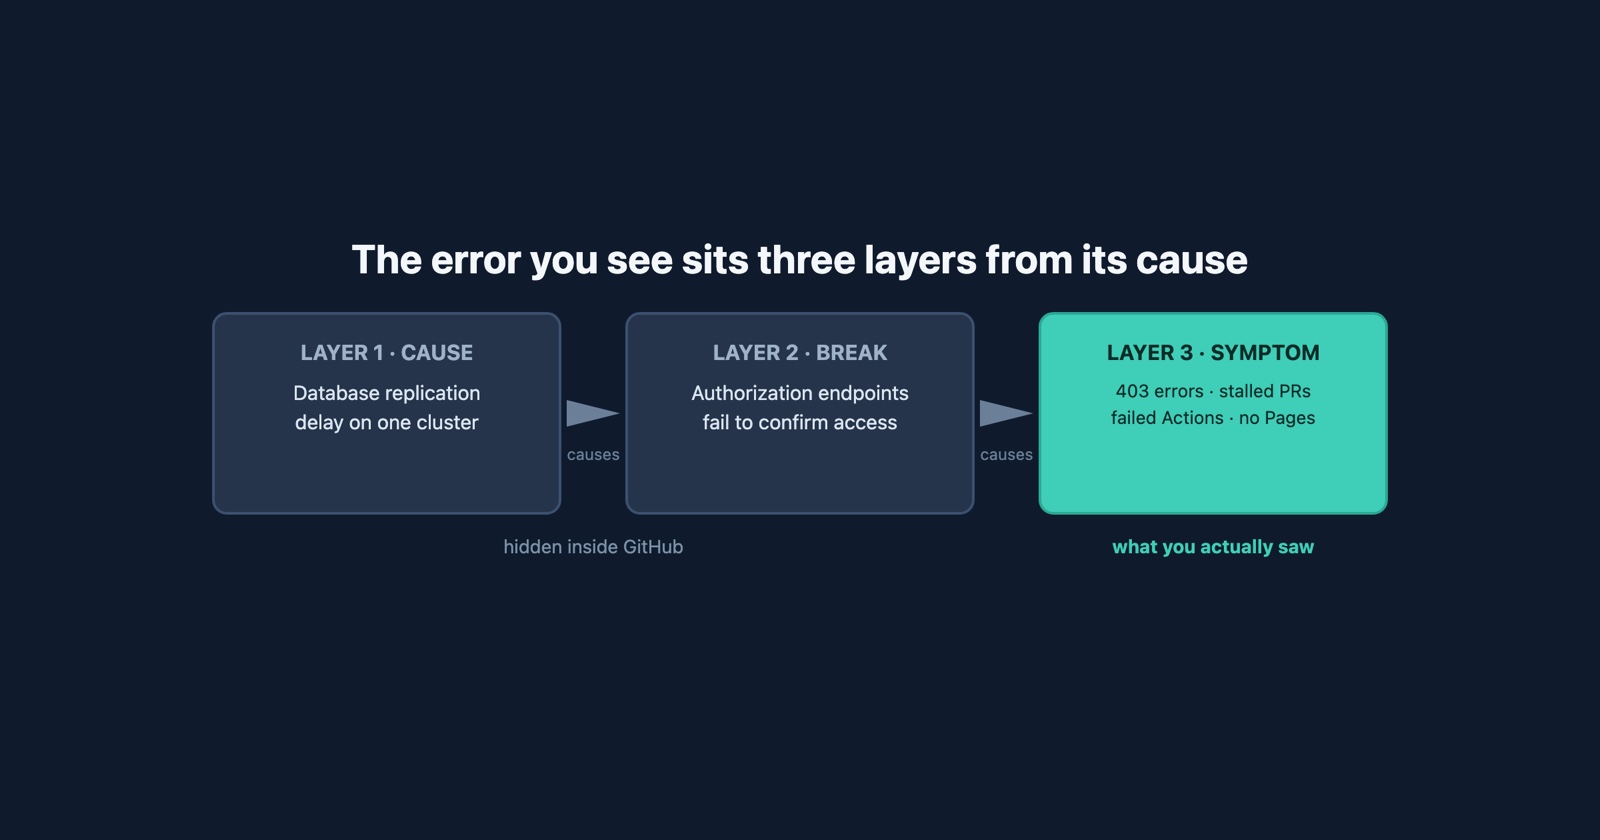
We’re seeing increased database replication delays on collab which is causing increased error rates in authorization endpoints and follow-on increased error rates across the system.
Leggetela come una catena. Un cluster di database è rimasto indietro nella replica. Questo ha fatto fallire gli endpoint che decidono se vi è permesso fare qualcosa. E siccome quasi tutto pone quella domanda prima di fare qualunque cosa, quasi tutto ha cominciato a fallire.
Tre strati: la causa, ciò che la causa ha rotto, e le cose che si sono rotte per questo. Solo l’ultimo strato era visibile a chiunque fuori da GitHub.
Come appariva da dove stavate voi
Se lavoravate sabato mattina, non avete visto un ritardo di replica. Avete visto uno di questi:
- Un
403dall’API su una richiesta che ieri funzionava. - Una pagina di pull request che non caricava, o caricava senza i suoi check.
- Un’esecuzione di Actions morta con un errore sui permessi, o su niente in particolare.
- Pages che non si pubblicavano.
Nessuno di questi dice “un database è indietro”. Ognuno dice qualcosa di più vicino a “il vostro account, il vostro token o il vostro codice sono sbagliati”. Un 403 in particolare è l’errore che vi dice che sa chi siete e che la risposta è no, che è un messaggio dal suono molto specifico da ricevere perché una replica da qualche parte è indietro di qualche secondo.
Questa è la forma generale, e merita un nome: l’errore che vedete è un sintomo, e il sintomo può stare a diversi strati dalla causa. Gli strati non sono un inganno. Ogni sistema nella catena ha riportato onestamente ciò che vedeva. L’endpoint di autorizzazione davvero non poteva confermare che foste autorizzati; l’API davvero doveva rifiutare. Il messaggio era vero a ogni passo e inutile all’ultimo.
Perché questo conta più del disservizio
Ottantanove minuti di sabato sono un incidente piccolo, e GitHub lo ha gestito bene: una voce di stato in pochi minuti, una causa dichiarata entro venti, scarico del carico per recuperare invece di aspettare che la replica si rimettesse in pari da sola, e la promessa dell’analisi completa. È così che si presenta il lavoro fatto bene, e vale la pena dirlo.
Il motivo per scriverne è che la stessa forma a tre strati sta sotto la maggior parte dei bug segnalati male, e sabato ne è un esemplare insolitamente pulito.
Quando qualcuno dice “ho preso un 403”, sta riportando lo strato tre. Quando uno sviluppatore legge “403” e comincia a controllare i permessi della persona, sta facendo debug sullo strato due. La causa stava nello strato uno, in un posto che nessuno dei due poteva vedere, e né la segnalazione né l’indagine ci arriveranno ragionando a partire dal messaggio. Il messaggio è la categoria. Non è il caso. Tutta la famiglia degli errori HTTP funziona così: ognuno nomina un tipo di fallimento e tace quello preciso.
Ciò che chiude il divario non è un’interpretazione migliore del codice. Sono i fatti intorno: quale richiesta, a che ora, accanto a cos’altro. Sabato il fatto intorno era che tutti lo vedevano nello stesso momento, che è la domanda su cui è costruito l’articolo precedente sul distinguere il vostro bug dal loro disservizio e che non serve ripetere qui.
Cosa annotare quando non capita a tutti
Il caso difficile è quello che non sta sulla pagina di stato di nessuno. Il vostro sistema ha gli stessi strati: una query lenta fa andare in timeout un servizio, che fa fallire una pagina. La persona che lo incontra riceve lo strato tre, e ciò che annota decide se qualcuno potrà risalire fino allo strato uno.
Quindi la segnalazione utile non è una diagnosi. È il sintomo dichiarato con esattezza, con la sua
ora e il suo contesto, e senza teoria allegata. “403 da /repos/x/y/pulls alle 09:41 UTC, tre
tentativi, la stessa chiamata era riuscita alle 08:50” è una segnalazione che qualcuno può
confrontare con un grafico di replica. “Credo che il mio token sia scaduto” è una teoria che lo
manda allo strato sbagliato.
Session Replay
Estensione Chrome gratuita. Un clic sulla pagina che si comporta male cattura lo screenshot, la console e il log di rete, e vi dà un link da incollare nel ticket.
Il log di rete è la richiesta esatta, lo stato esatto e il minuto esatto, catturati senza che nessuno debba decidere quale strato crede di stare guardando. È il materiale con cui si costruisce un’analisi della causa, che sia quella di GitHub o la vostra.
In un paragrafo
Il 13 settembre 2026 GitHub è stato degradato per ottantanove minuti, e la sua stessa pagina di stato ne ha nominato la forma in una frase: un ritardo di replica del database in un cluster ha causato fallimenti negli endpoint di autorizzazione, che hanno causato fallimenti in tutto il sistema. Tre strati, e solo l’ultimo era visibile da fuori, come 403 e pagine che non caricavano. La lezione non riguarda GitHub, che lo ha gestito bene e non deve scuse a nessuno. Riguarda il fatto che l’errore che vedete è un sintomo che può stare a diversi strati dalla sua causa, quindi la segnalazione che aiuta è il sintomo dichiarato con esattezza, con ora e contesto, invece di una teoria su cosa significhi.