Le samedi 13 septembre 2026, de 09:16 à 10:44 UTC, GitHub a connu ce que sa page de statut a classé comme un incident critique : requêtes API, Issues, Pull Requests, Actions et Pages dégradés pendant quatre-vingt-neuf minutes. Il a été résolu en milieu de matinée en Europe, avant que la majeure partie des États-Unis ne soit réveillée, et une analyse détaillée de la cause racine est promise. Ceci n’est pas cette analyse, et ne devine pas ce qu’elle dira.
Ce dont il s’agit, c’est d’une phrase que GitHub a publiée vingt minutes après le début de l’incident, parce que cette phrase est un meilleur exemple pédagogique que la plupart des postmortems.
La ligne qui mérite d’être lue deux fois
À 09:36 UTC, la page de statut disait :
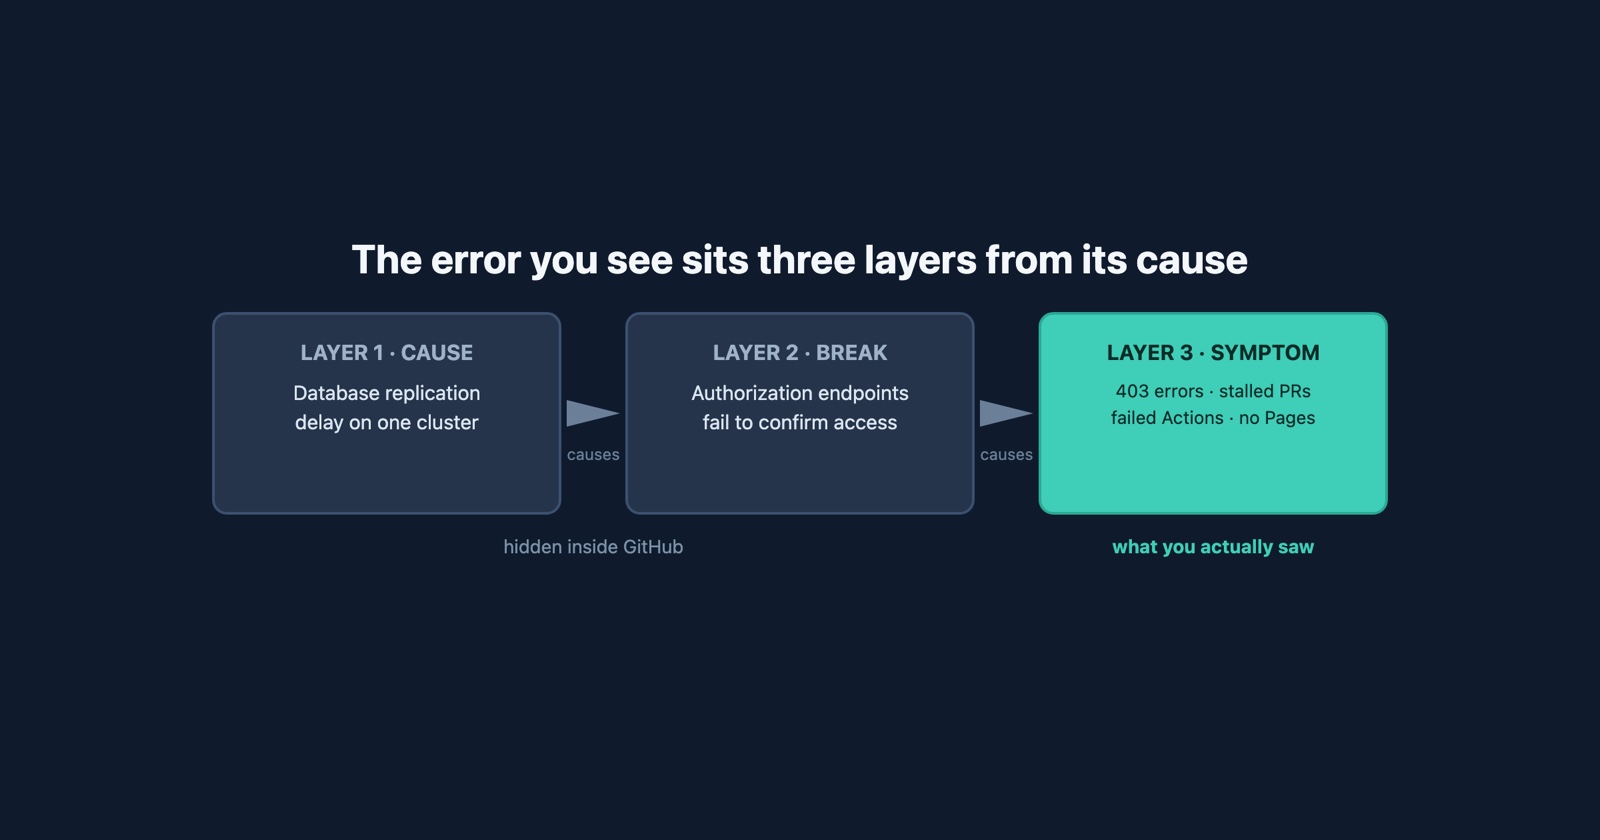
We’re seeing increased database replication delays on collab which is causing increased error rates in authorization endpoints and follow-on increased error rates across the system.
Lisez-la comme une chaîne. Un cluster de base de données a pris du retard de réplication. Cela a fait échouer les points d’accès qui décident si vous avez le droit de faire quelque chose. Et comme presque tout pose cette question avant d’agir, presque tout s’est mis à échouer aussi.
Trois couches : la cause, ce que la cause a cassé, et les choses qui ont cassé à cause de cela. Seule la dernière couche était visible pour quiconque hors de GitHub.
À quoi cela ressemblait de là où vous étiez
Si vous travailliez samedi matin, vous n’avez pas vu un retard de réplication. Vous avez vu l’une de ces choses :
- Un
403de l’API sur une requête qui marchait la veille. - Une page de pull request qui ne chargeait pas, ou chargeait sans ses vérifications.
- Une exécution Actions morte sur une erreur de permissions, ou sur rien de particulier.
- Des Pages qui ne se déployaient pas.
Aucune ne dit « une base de données est en retard ». Chacune dit plutôt « votre compte, votre jeton ou votre code est faux ». Une 403 en particulier est l’erreur qui vous dit qu’elle sait qui vous êtes et que la réponse est non, ce qui est un message qui semble très précis à recevoir parce qu’un réplica quelque part a quelques secondes de retard.
C’est la forme générale, et elle mérite d’être nommée : l’erreur que vous voyez est un symptôme, et le symptôme peut se trouver à plusieurs couches de la cause. Les couches ne sont pas une tromperie. Chaque système de la chaîne a rapporté honnêtement ce qu’il voyait. Le point d’accès d’autorisation ne pouvait réellement pas confirmer que vous étiez autorisé ; l’API devait réellement refuser. Le message était vrai à chaque étape et inutile à la dernière.
Pourquoi cela compte plus que la panne
Quatre-vingt-neuf minutes un samedi, c’est un petit incident, et GitHub l’a bien géré : une entrée de statut en quelques minutes, une cause énoncée en moins de vingt, un délestage de charge pour récupérer plutôt qu’attendre que le réplica rattrape seul, et la promesse de l’analyse complète. C’est à cela que ressemble le bon travail, et cela vaut la peine de le dire.
La raison de l’écrire est que la même forme à trois couches se trouve sous la plupart des bugs mal signalés, et samedi en est un spécimen inhabituellement net.
Quand quelqu’un dit « j’ai eu une 403 », il rapporte la couche trois. Quand un développeur lit « 403 » et commence à vérifier les permissions de la personne, il débogue la couche deux. La cause était dans la couche un, à un endroit que ni l’un ni l’autre ne pouvait voir, et ni le rapport ni l’enquête ne l’atteindront en raisonnant à partir du message. Le message est la catégorie. Il n’est pas le cas. Toute la famille des erreurs HTTP fonctionne ainsi : chacune nomme un type de défaillance et tait la défaillance précise.
Ce qui comble l’écart n’est pas une meilleure interprétation du code. Ce sont les faits environnants : quelle requête, à quelle heure, à côté de quoi d’autre. Samedi, le fait environnant était que tout le monde le voyait en même temps, ce qui est la question autour de laquelle l’article précédent sur distinguer votre bug de leur panne est construit et qu’il est inutile de répéter ici.
Quoi noter quand ce n’est pas tout le monde
Le cas difficile est celui qui n’est sur la page de statut de personne. Votre propre système a les mêmes couches : une requête lente fait expirer un service, ce qui fait échouer une page. La personne qui la rencontre reçoit la couche trois, et ce qu’elle note décide si quelqu’un pourra remonter jusqu’à la couche un.
Le rapport utile n’est donc pas un diagnostic. C’est le symptôme énoncé exactement, avec son heure
et son contexte, sans théorie attachée. « 403 depuis /repos/x/y/pulls à 09:41 UTC, trois
nouvelles tentatives, le même appel a réussi à 08:50 » est un rapport que quelqu’un peut aligner
sur un graphique de réplication. « Je pense que mon jeton a expiré » est une théorie qui l’envoie
vers la mauvaise couche.
Session Replay
Extension Chrome gratuite. Un clic sur la page qui se comporte mal capture la capture d'écran, la console et le journal réseau, et vous donne un lien à coller dans le ticket.
Le journal réseau, c’est la requête exacte, le statut exact et la minute exacte, capturés sans que personne n’ait à décider quelle couche il croit regarder. C’est la matière dont se construit une analyse de cause racine, qu’elle soit celle de GitHub ou la vôtre.
En un paragraphe
Le 13 septembre 2026, GitHub a été dégradé pendant quatre-vingt-neuf minutes, et sa propre page de statut en a nommé la forme en une phrase : un retard de réplication de base de données dans un cluster a causé des échecs dans les points d’accès d’autorisation, qui ont causé des échecs dans tout le système. Trois couches, et seule la dernière était visible de l’extérieur, sous forme de 403 et de pages qui ne chargeaient pas. La leçon ne porte pas sur GitHub, qui a bien géré et ne doit d’excuses à personne. Elle est que l’erreur que vous voyez est un symptôme qui peut se trouver à plusieurs couches de sa cause, si bien que le rapport qui aide est le symptôme énoncé exactement, avec son heure et son contexte, plutôt qu’une théorie sur ce qu’il signifie.