El sábado 13 de septiembre de 2026, de 09:16 a 10:44 UTC, GitHub tuvo lo que su página de estado clasificó como incidente crítico: las peticiones a la API, Issues, Pull Requests, Actions y Pages degradados durante ochenta y nueve minutos. Se resolvió a media mañana en Europa, antes de que la mayor parte de Estados Unidos estuviera despierta, y hay prometido un análisis detallado de la causa raíz. Esto no es ese análisis, y no adivina lo que dirá.
De lo que trata es de una frase que GitHub publicó a los veinte minutos del incidente, porque esa frase es mejor ejemplo didáctico que la mayoría de los postmortems.
La línea que merece leerse dos veces
A las 09:36 UTC la página de estado decía:
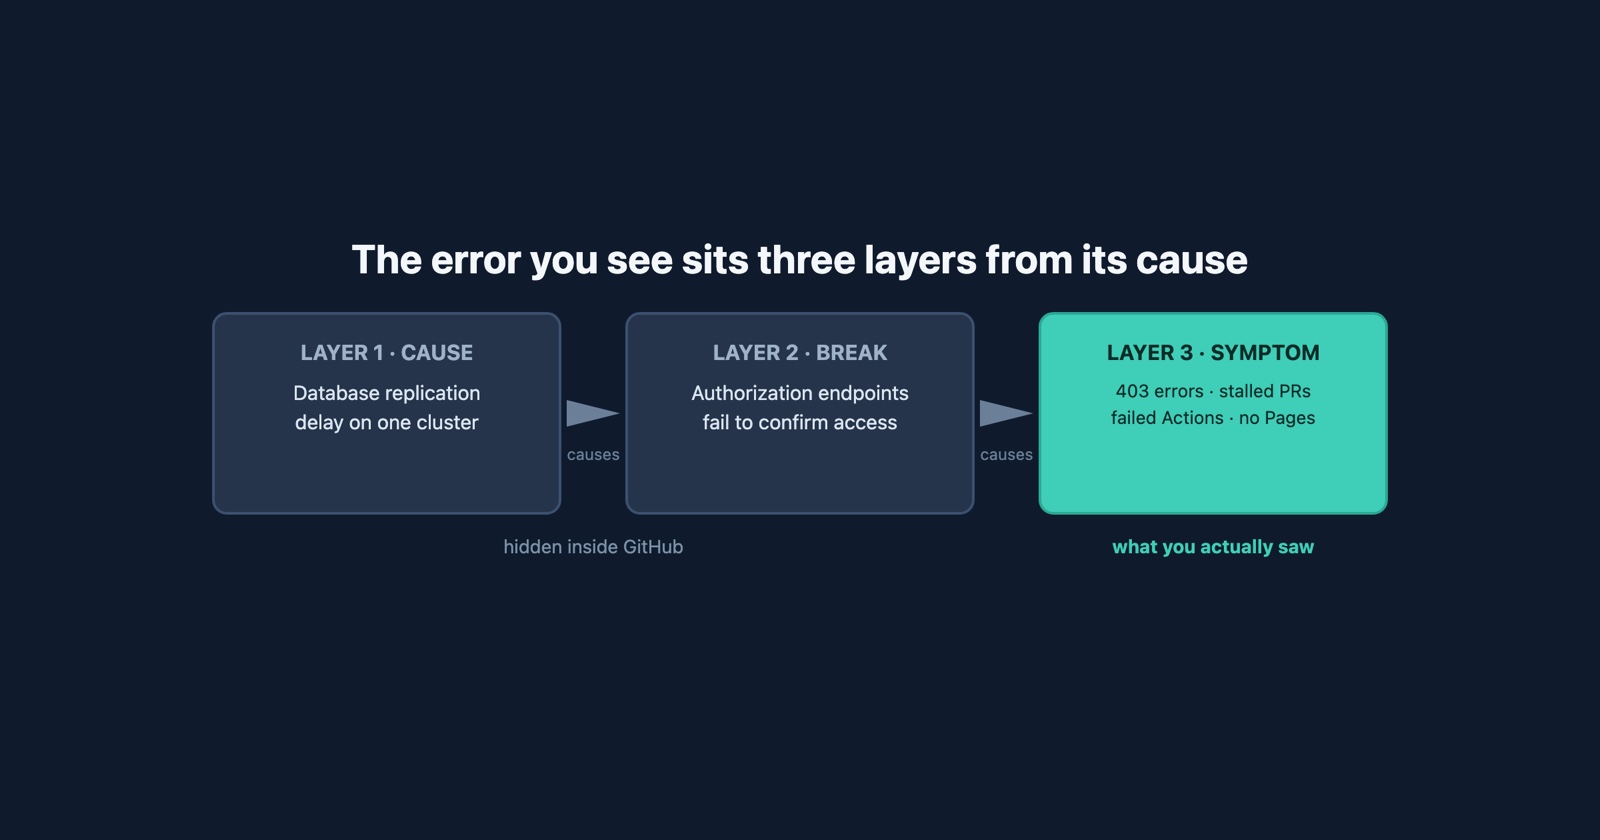
We’re seeing increased database replication delays on collab which is causing increased error rates in authorization endpoints and follow-on increased error rates across the system.
Léala como una cadena. Un clúster de base de datos se quedó atrás en la replicación. Eso hizo que los endpoints que deciden si usted puede hacer algo empezaran a fallar. Y como casi todo hace esa pregunta antes de hacer nada, casi todo empezó a fallar también.
Tres capas: la causa, lo que la causa rompió, y las cosas que se rompieron por eso. Solo la última capa era visible para alguien fuera de GitHub.
Cómo se veía desde donde usted estaba
Si trabajaba el sábado por la mañana, no vio un retraso de replicación. Vio uno de estos:
- Un
403de la API en una petición que ayer funcionaba. - Una página de pull request que no cargaba, o cargaba sin sus checks.
- Una ejecución de Actions que moría con un error sobre permisos, o sobre nada en particular.
- Pages sin desplegar.
Nada de eso dice “una base de datos va con retraso”. Cada uno dice algo más parecido a “su cuenta, su token o su código están mal”. Un 403 en particular es el error que le dice que sabe quién es usted y que la respuesta es no, que es un mensaje que suena muy específico para recibirlo porque una réplica en alguna parte va unos segundos atrasada.
Esa es la forma general, y merece un nombre: el error que ve es un síntoma, y el síntoma puede estar a varias capas de la causa. Las capas no son un engaño. Cada sistema de la cadena informó con honestidad de lo que vio. El endpoint de autorización de verdad no pudo confirmar que usted tenía permiso; la API de verdad tuvo que negarse. El mensaje era cierto en cada paso e inútil en el último.
Por qué esto importa más que la caída
Ochenta y nueve minutos un sábado es un incidente pequeño, y GitHub lo gestionó bien: una entrada de estado en minutos, una causa enunciada en menos de veinte, desprendimiento de carga para recuperarse en lugar de esperar a que la réplica se pusiera al día sola, y la promesa del análisis completo. Así es como se ve hacerlo bien, y merece la pena decirlo.
La razón para escribirlo es que la misma forma de tres capas está debajo de la mayoría de los bugs que se reportan mal, y el sábado es un espécimen inusualmente limpio.
Cuando alguien dice “me salió un 403”, está reportando la capa tres. Cuando un desarrollador lee “403” y se pone a comprobar los permisos de la persona, está depurando la capa dos. La causa estaba en la capa uno, en un sitio que ninguno de los dos podía ver, y ni el informe ni la investigación llegarán a ella razonando a partir del mensaje. El mensaje es la categoría. No es el caso. Toda la familia de errores HTTP funciona así: cada uno nombra un tipo de fallo y se calla el concreto.
Lo que cierra la brecha no es una mejor interpretación del código. Son los hechos alrededor: qué petición, a qué hora, junto a qué más. El sábado el hecho alrededor era que todo el mundo lo veía a la vez, que es la pregunta sobre la que está construido el artículo anterior sobre distinguir su bug de la caída de ellos y que no hace falta repetir aquí.
Qué apuntar cuando no le pasa a todo el mundo
El caso difícil es el que no está en la página de estado de nadie. Su propio sistema tiene las mismas capas: una consulta lenta que hace que un servicio agote el tiempo, que hace que una página falle. La persona que lo sufre recibe la capa tres, y lo que apunte decide si alguien puede volver andando hasta la capa uno.
Así que el informe útil no es un diagnóstico. Es el síntoma enunciado con exactitud, con su hora y
su contexto, y sin teoría adjunta. “403 desde /repos/x/y/pulls a las 09:41 UTC, tres reintentos,
la misma llamada funcionó a las 08:50” es un informe que alguien puede cruzar con una gráfica de
replicación. “Creo que mi token caducó” es una teoría que lo manda a la capa equivocada.
Session Replay
Extensión gratuita de Chrome. Un clic en la página que se comporta mal captura la captura de pantalla, la consola y el registro de red, y le da un enlace para pegar en el ticket.
El registro de red es la petición exacta, el estado exacto y el minuto exacto, capturados sin que nadie tenga que decidir qué capa cree estar mirando. Ese es el material del que se construye un análisis de causa raíz, sea el de GitHub o el suyo.
En un párrafo
El 13 de septiembre de 2026 GitHub estuvo degradado ochenta y nueve minutos, y su propia página de estado nombró la forma del problema en una frase: un retraso de replicación de base de datos en un clúster causó fallos en los endpoints de autorización, que causaron fallos en todo el sistema. Tres capas, y solo la última era visible desde fuera, como 403 y páginas que no cargaban. La lección no va de GitHub, que lo gestionó bien y no debe disculpas a nadie. Va de que el error que ve es un síntoma que puede estar a varias capas de su causa, así que el informe que ayuda es el síntoma enunciado con exactitud, con su hora y contexto, y no una teoría sobre lo que significa.