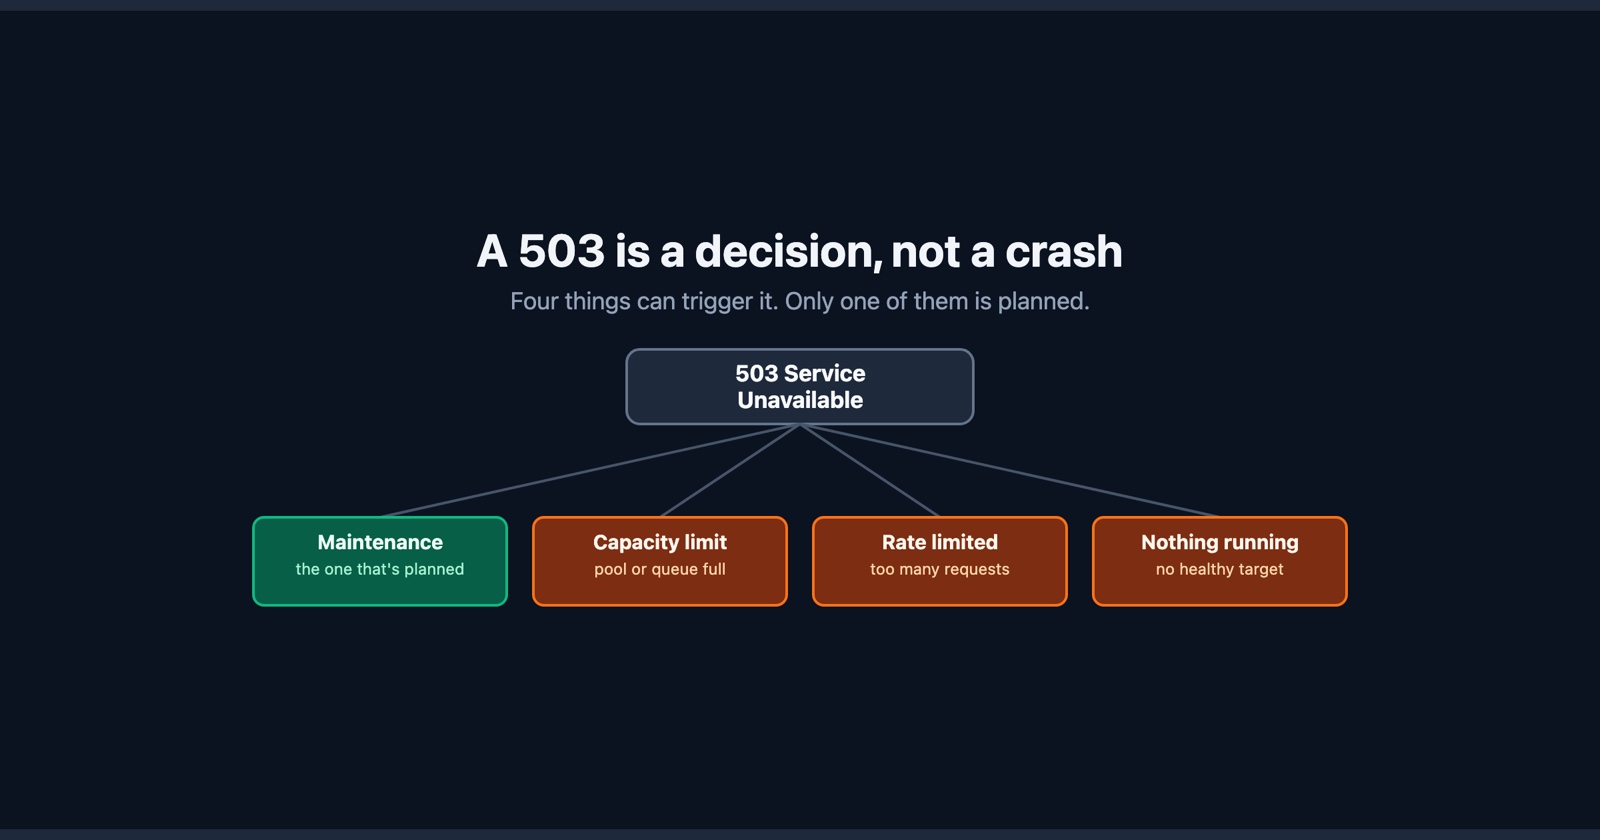
Un 503 Service Unavailable è l’unico errore del server che di solito è voluto. Qualcosa ha deciso che questa richiesta non sarebbe stata servita in questo momento, e lo ha detto, invece di provarci e fallire.
Questo lo rende il caso strano della sua famiglia. Un 500 è codice che si è rotto mentre girava. Un 502 è un proxy che riceve una risposta inutilizzabile da ciò che ha dietro. Un 504 è quella stessa cosa che non risponde mai in tempo. Tutti e tre sono fallimenti. Un 503 è una decisione.
Le quattro cose che prendono quella decisione
Da un browser sembrano identiche e significano cose completamente diverse per chi gestisce il sito.
Modalità manutenzione. Qualcuno ha messo deliberatamente il sito dietro una pagina di attesa mentre gira una migrazione o atterra un deploy. Qui il 503 funziona esattamente come previsto, ed è l’unico caso in cui la risposta giusta è tornare più tardi.
L’applicazione non accetta connessioni. Tutti i worker sono occupati, il pool di connessioni è pieno, la coda davanti è al limite. Il server davanti è ancora in piedi e risponde ancora, quindi risponde con l’unica cosa onesta che ha: non adesso.
Un rate limiter. Voi, o la rete su cui vi trovate, avete inviato più richieste di quante una soglia ne permetta. Alcuni servizi usano un 429 per questo, che è più specifico e più utile; molti usano il 503, e una CDN messa davanti a un’applicazione spesso trasforma l’uno nell’altro.
Non gira niente. Un autoscaler che non ha raggiunto un picco di traffico, un deploy in cui la nuova versione non ha passato il suo health check, un container morto e non sostituito. Il load balancer ha destinazioni sane a cui mandare il traffico, non ne trova nessuna, e restituisce un 503 perché non c’è dove mandarlo.
Solo la prima di queste è pianificata. Le altre tre sono il sistema che dice di essere al limite o di aver perso qualcosa, nella formula cortese riservata a una condizione temporanea.
L’header che quasi nessuno legge
Un 503 è il codice di stato a cui è attaccata una risposta. La risposta può portare
Retry-After, che dice o quanti secondi aspettare o la data e l’ora esatte in cui tornare:
HTTP/1.1 503 Service Unavailable
Retry-After: 120
Content-Type: text/html
Quello è il sito che vi dice che ci vorranno due minuti. Le pagine di manutenzione ben configurate lo impostano, le CDN lo lasciano passare, e mandarlo non costa nulla.
Da lì seguono due cose, e puntano in direzioni opposte. Se state scrivendo un client, leggete
l’header invece di inventarvi il vostro backoff: a un servizio che vi ha detto 120 secondi e
riceve un nuovo tentativo ogni due si sta chiedendo di servire proprio le richieste che ha appena
detto di non poter servire. E se gestite il sito, impostatelo. Un 503 con Retry-After è un
motore di ricerca che tiene la pagina invece di trattarla come sparita, ed è un client che
aspetta come si deve invece di uno che si somma al carico che ha causato il problema.
Se siete il visitatore
Un 503 di solito significa aspettare e, cosa insolita per un errore, aspettare spesso funziona. Ricaricate dopo un minuto o due. Se è un deploy o un picco, si risolve da solo, e nel vostro browser non c’è nulla che lo tocchi in un senso o nell’altro.
L’unica cosa che vale la pena controllare è se capita solo a voi. Un 503 che vedono tutti è la capacità del sito o la sua finestra di manutenzione. Un 503 che vedete voi e non un collega su un’altra rete è più probabilmente un rate limiter che ce l’ha con il vostro indirizzo, e un telefono in rete mobile risponde a quella domanda in una decina di secondi. A quella distinzione si riduce tutto il distinguere il vostro bug dal loro disservizio.
Se il sito è vostro
La risposta non vi dice quasi nulla ma, a differenza di un 500, la causa di solito sta davanti all’applicazione e non dentro.
Partite da quale strato lo ha emesso. Un 503 di nginx, di un load balancer o di una CDN è identico per il browser e arriva da tre posti diversi con tre log diversi. Spesso lo tradisce il body, perché ognuno di loro porta la propria pagina predefinita, e gli header di risposta di solito nominano ciò che li ha prodotti. Se la vostra applicazione non è mai girata, il suo log sarà in silenzio, e quel silenzio è una prova e non un vicolo cieco.
Poi la domanda ovvia, facile da saltare quando un sito è giù: la modalità manutenzione è ancora attiva? Una pagina di attesa che doveva durare dieci minuti ed è sopravvissuta al deploy che l’aveva alzata è un 503 abbastanza comune da controllare per primo, ed escluderlo richiede secondi.
Se è capacità, la soluzione non sta nella pagina di errore. Guardate la saturazione dei worker, i limiti del pool e la profondità della coda lungo tutta la finestra invece delle richieste che hanno preso il 503, perché quelle che hanno preso il 503 sono quelle arrivate dopo l’inizio del problema. Se sono gli health check, la domanda è se il check ha ragione a dire che l’applicazione non è sana o se sta fallendo per una ragione tutta sua, e questi due casi vogliono risposte opposte.
Perché un 503 merita di essere segnalato bene
La maggior parte dei 503 si risolve. È proprio questo a renderli sfuggenti: quando qualcuno va a indagare, il sito è tornato e non c’è nulla da guardare. Quello che resta è il ricordo che qualcuno ha di una pagina di errore, e un sospetto su più o meno quando.
I problemi di capacità e i rollout andati male non si ripetono a comando. Succedono nel momento in cui il traffico ha superato una linea, e la prova è una finestra in un grafico che nessuno sa di dover andare a guardare a meno che qualcuno non abbia annotato quando è successo.
Session Replay
Estensione Chrome gratuita. Un clic sulla pagina che si comporta male cattura lo screenshot, la console e il log di rete, e vi dà un link da incollare nel ticket.
Per un 503 la parte utile è il timestamp e gli header di risposta: quale strato ha risposto, che
Retry-After ha dichiarato, e il minuto esatto. Basta questo per trovare la finestra giusta in
una dashboard, che è dove sta davvero la risposta.
In un paragrafo
Un 503 Service Unavailable significa che qualcosa ha scelto di non servire la richiesta invece di
provarci e fallire, ed è questo a separarlo da un 500, un 502 e un 504. Quattro cose fanno quella
scelta: la modalità manutenzione, un’applicazione rimasta senza capacità, un rate limiter, e un
load balancer senza nulla di sano a cui mandare il traffico. Solo la prima è pianificata. Se
siete di passaggio, aspettate un minuto e poi controllate se lo vede anche qualcun altro. Se il
sito è vostro, stabilite prima di tutto quale strato ha risposto, accertatevi che la modalità
manutenzione non sia semplicemente rimasta attiva, e impostate Retry-After perché i client in
attesa aspettino come si deve invece di sommarsi al carico.