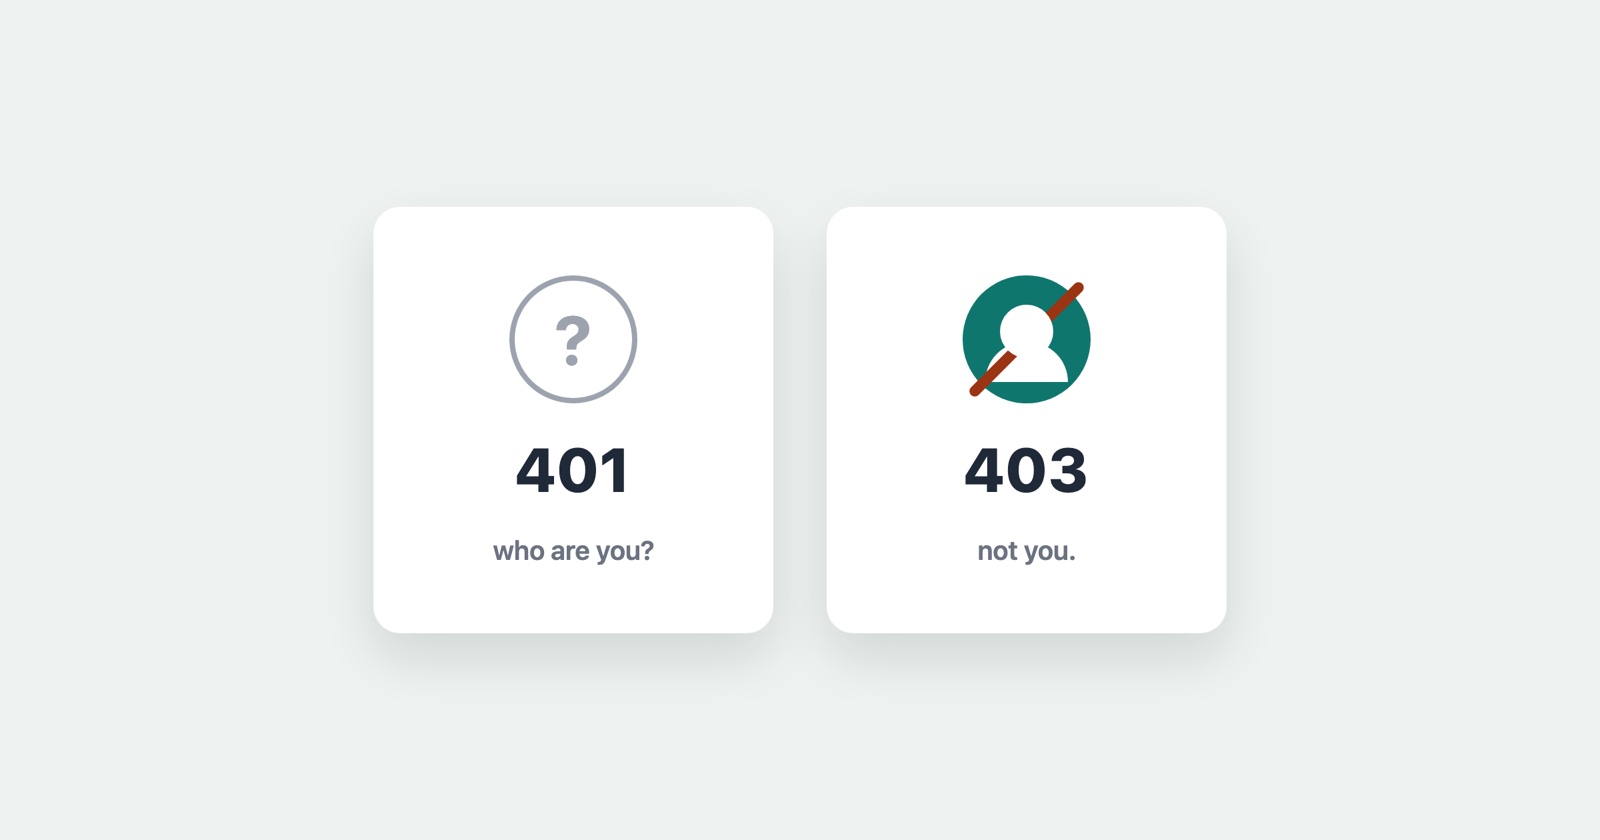
401 et 403 signifient tous deux que vous n’avez pas obtenu la page, et ils sont constamment confondus l’un avec l’autre, dans les messages d’erreur et les rapports de bugs. La différence entre eux est petite à lire mais grande pour agir : l’un concerne qui vous êtes, l’autre concerne ce que vous êtes autorisé à faire.
Les confondre vous envoie corriger la mauvaise chose. Voici donc la distinction, ce que chacun dit vraiment, et comment savoir lequel vous avez réellement.
La version en une ligne
401 Non authentifié signifie que le serveur ne sait pas qui vous êtes. Vous n’êtes pas connecté, ou l’identifiant que vous avez envoyé était absent, incorrect ou expiré. Si vous vous connectez correctement, la demande réussirait.
403 Interdit signifie que le serveur sait exactement qui vous êtes, et vous ne pouvez toujours pas. Vous êtes connecté, votre identifiant est correct, et ce compte particulier n’est simplement pas autorisé à faire cette chose particulière. Se reconnecter ne change rien, car être connecté n’a jamais été le problème.
Simplement dit : 401 signifie « Je ne vous connais pas », 403 signifie « Je vous connais, et non ».
Le libellé est un accident historique qui aggrave les choses. 401 est étiqueté « Non autorisé » alors qu’il signifie vraiment « non authentifié » - le serveur n’a pas pu établir qui vous êtes. 403 est celui qui concerne vraiment l’autorisation. Les noms sont figés pour des raisons de compatibilité, lisez au-delà pour comprendre ce que chaque code fait.
Comment savoir lequel vous avez
Regardez si vous êtes connecté quand cela se produit.
Si vous êtes déconnecté, ou si la demande ne contenait aucun cookie de session ou jeton, un 401 est la réponse attendue et correcte, et la solution est de vous authentifier. Si la même demande fonctionne une fois que vous êtes connecté, c’était seulement un 401.
Si vous êtes connecté - correctement, avec une session que le serveur accepte ailleurs - et qu’une action ou une page particulière retourne l’erreur, vous regardez un 403. Le compte est authentifié et la réponse est toujours non. Se déconnecter et se reconnecter, effacer les cookies ou essayer un autre navigateur ne le changeront pas, et chacun de ceux-ci est une demi-heure gaspillée courante en traitant un 403 comme s’il s’agissait d’un 401.
Un piège qui vaut la peine d’être mentionné : certains serveurs retournent délibérément 404 Non trouvé alors qu’ils veulent dire 403, pour éviter de confirmer qu’une ressource existe. Si une URL que vous savez être réelle revient comme « non trouvée » uniquement quand vous manquez de permission pour y accéder, la vraie réponse est 403 en déguisement.
Si c’est votre site
Le code que vous envoyez est une décision, pas un détail, car il dit à la personne à l’autre bout lequel de deux problèmes très différents elle a.
Envoyez 401 quand la demande n’est pas authentifiée - aucun identifiant, ou un que le serveur
ne peut pas vérifier - et incluez un en-tête WWW-Authenticate pour que le client sache comment
il est censé se connecter. Un 401 est une invitation à s’authentifier et réessayer.
Envoyez 403 quand la demande est authentifiée mais non autorisée. L’utilisateur est qui il dit qu’il est et ce compte ne peut pas faire cela. Ne répondez pas avec un 401, car un 401 lui dit de se reconnecter, et il le fera, et cela échouera à nouveau, et la boucle lui n’enseigne rien sauf que votre site est cassé.
La cause la plus courante d’un 403 sur votre propre site est une vérification de permission ou de rôle : un utilisateur atteignant une route admin, une clé API sans la portée pour un endpoint, un objet qui appartient à un autre compte. La cause la plus courante d’un 401 inattendu est une session ou un jeton qui a expiré sans que le front-end ne le remarque, donc il continue d’envoyer un identifiant que le serveur a cessé d’honorer.
Pourquoi il vaut la peine de capturer plutôt que de décrire
« J’ai eu une erreur et cela ne m’a pas laissé entrer » est le rapport que vous obtenez généralement, et il convient aux deux codes de manière égale, ce qui est exactement pourquoi cela n’aide pas. Un 401 et un 403 semblent identiques à un utilisateur - une page qu’il voulait et qu’il n’a pas obtenue - et la seule information qui les distingue, le code de statut, est celle qu’une personne ne pense presque jamais à lire.
La demande elle-même porte la réponse : le statut, si un identifiant est allé avec, et ce que le serveur a dit en retour. Capturé au moment où il a échoué, cela transforme « cela ne m’a pas laissé entrer » en « un 403 sur cet endpoint en étant connecté comme ce compte », ce qui est un bug de permission que quelqu’un peut trouver - plutôt qu’un problème de connexion que quelqu’un chassera pendant une heure en premier.
Session Replay
Extension Chrome gratuite. Un clic sur la page qui se comporte mal capture la capture d'écran, la console et le journal réseau, et vous remet un lien à coller dans le ticket.
Le journal réseau contient la demande échouée avec son statut et si un identifiant est allé avec, donc quiconque récupère le rapport peut voir d’un coup d’oeil s’il regardait un 401 ou un 403 - et n’a pas besoin de reproduire l’état de connexion pour le savoir. Pour vérifier si une URL vous retourne l’un de ceux-ci maintenant, le vérificateur de code de statut HTTP la demande et rapporte le code qui revient.
En un paragraphe
Un 401 Non authentifié signifie que le serveur ne sait pas qui vous êtes et vous devriez vous authentifier ; un 403 Interdit signifie qu’il sait exactement qui vous êtes et vous ne pouvez toujours pas, donc se reconnecter n’aidera pas. Distinguez-les en regardant si vous étiez connecté quand cela s’est produit, envoyez le bon de votre propre site afin que personne ne soit envoyé en boucle de connexion pour un problème de permission, et capturez la demande échouée plutôt que de la décrire, car le code de statut est la réponse complète et la seule chose qu’un utilisateur ne lit jamais.